X-Tree 2026: Arsitektur Tokenisasi Pengalaman Agen Otonom, X-Score Recursive Merging, dan Pelatihan Hierarki Skill ke Bobot Model Tanpa Ekstraksi LLM
Analisis arsitektur sistemik riset frontier AI agent dari University of Waterloo, Duke University, dan NUS (arXiv:2609.32993, Sitao Cheng, Xunjian Yin, Zhiyuan Sun, Victor Zhong et al., 2026): Mengapa paradigma pelatihan SFT dan RLVR pada flat action streams mengalami inefisiensi representasi dan mengapa skill library berbasis LLM prompt context gagal melakukan generalisasi di luar retrieval. Memperkenalkan X-Tree (eXperience Tree), metode penambangan hierarki sub-prosedur reusable secara deterministik murni tanpa satu pun pemanggilan LLM via metrik X-Score (recurrence x length x success rate). X-Tree mengintegrasikan hierarki pengalaman langsung ke bobot model melalui tiga mode pelatihan: (1) Offline RL dengan node sebagai instance GRPO parsial dan bonus penyelesaian berbasis kedalaman, (2) Online RLVR dengan adaptive skill bonus yang otomatis meluruh saat verifier informatif, serta (3) On-Policy Self-Distillation (OPSD) dengan X-Tree sebagai privileged context guru mandiri. Berhasil mendongkrak Success Rate WebArena hingga 22.9% pada Qwen2.5-7B (+4.5% dari SFT baseline) serta melesat hingga +4.9% pada ScienceWorld dan +4.6% graded score pada WebShop.
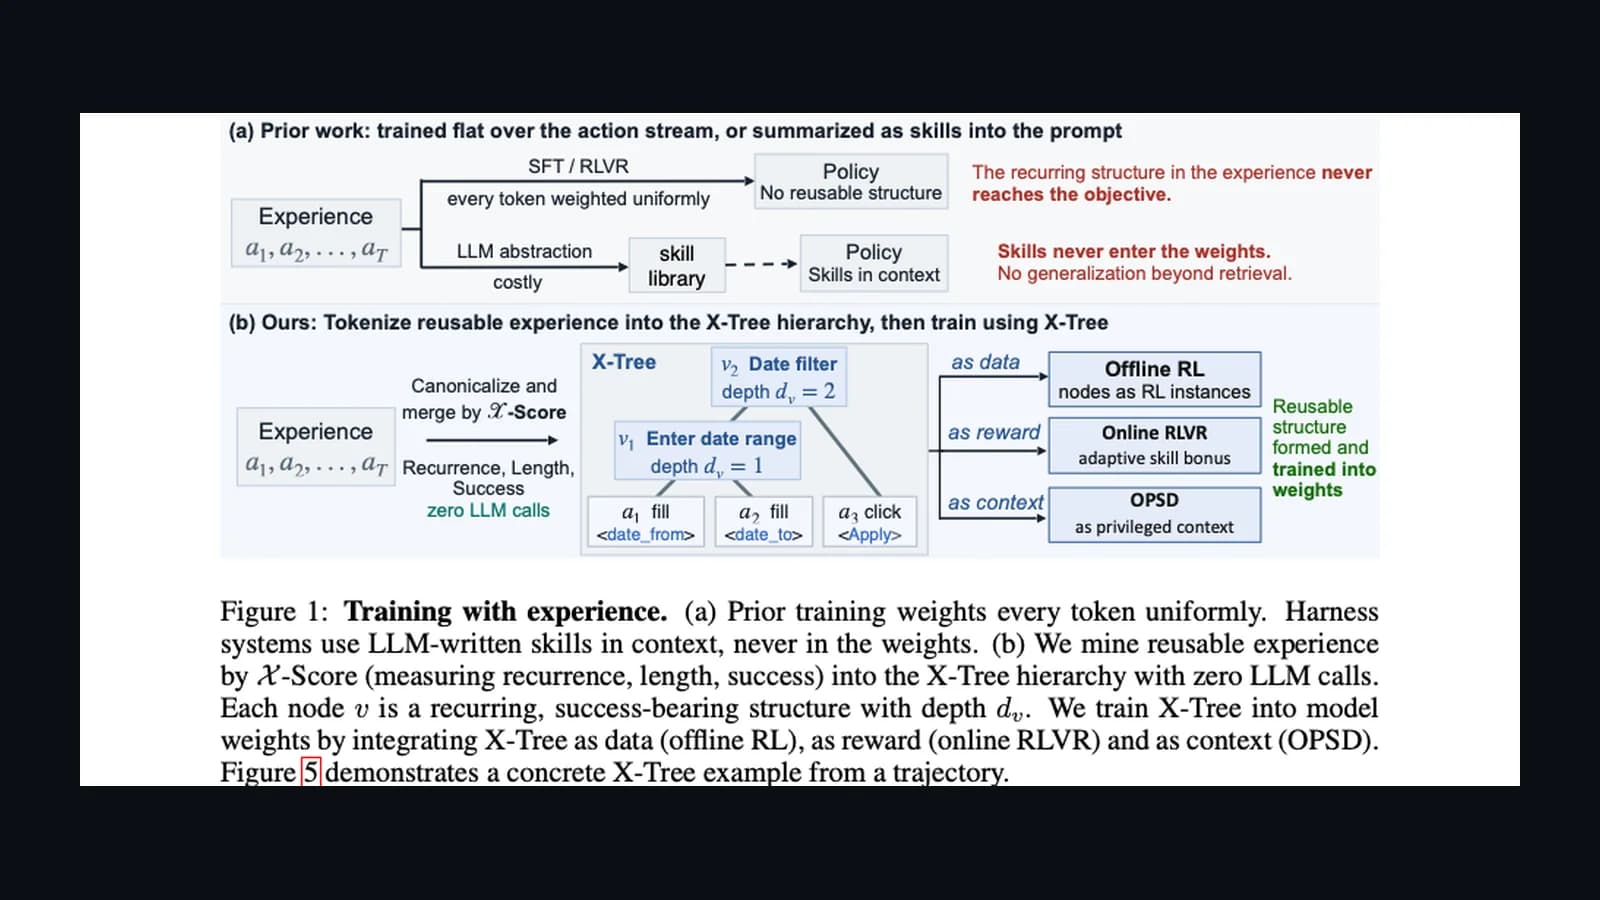
X-Tree: Mengapa Paradigma Pelatihan Agen pada Flat Action Streams Telah Kadaluwarsa dan Bagaimana Tokenisasi Pengalaman Mengubah Hierarki Skill Menjadi Bobot Model
Dalam ekosistem pengembangan agen otonom saat ini, proses pelatihan berbasis Supervised Fine-Tuning (SFT) dan Reinforcement Learning with Verifiable Rewards (RLVR) mengalami cacat fundamental: model memperlakukan seluruh deretan aksi (action streams) secara seragam dan datar (flat). Setiap token aksi diperlakukan dengan bobot yang sama, mengabaikan struktur modular hierarkis yang digunakan manusia untuk memecahkan masalah kompleks secara top-down. Solusi alternatif berupa skill library berbasis LLM prompt context (seperti ReAct harness atau Voyager) memiliki kelemahan fatal: menguras jatah konteks, memicu biaya latensi inference tinggi, dan sama sekali tidak tertanam ke dalam bobot parameter model sehingga tidak mampu melakukan generalisasi di luar pencarian memori. Riset frontier kolaboratif dari University of Waterloo, Duke University, dan National University of Singapore (arXiv:2609.32993) memperkenalkan X-Tree (eXperience Tree): metodologi penambangan hierarki skill secara deterministik dengan zero LLM calls via metrik X-Score, yang kemudian dilatihkan langsung ke bobot model melalui tiga integrasi revolusioner (Offline RL, Online RLVR adaptif, dan On-Policy Self-Distillation).
1. Tragedi Flat Action Stream: Mengapa Model Bahasa Agen Mengabaikan Struktur Sub-Prosedur
Dalam ilmu kognitif (cognitive science), Miller (1956) dan Botvinick et al. (2009) telah membuktikan bahwa kecerdasan biologis mengatasi batas kapasitas komputasi melalui mekanisme chunking—mengubah deretan aksi atomik menjadi sub-rutin hierarkis yang dapat digunakan berulang kali. Ketika seorang insinyur menavigasi dasbor Git, ia tidak memikirkan "gerakkan kursor 10 piksel, klik elemen #input, ketik huruf 'b', tekan enter". Ia berpikir pada level abstraksi: filter_date_range(from, to) lalu inspect_pull_request().
Sayangnya, metode pelatihan model AI saat ini membuang seluruh struktur kognitif ini:
- SFT & RLVR Konvensional Bersifat Flat: Menghitung gradien cross-entropy atau advantage policy secara token-per-token dengan bobot seragam. Trajektori yang langka dan mahal dieksploitasi dengan efisiensi yang sangat rendah karena transisi antar-tahap yang kritis tidak dibedakan dari ketukan tombol trivial.
- Skill Library Berbasis Prompt Tidak Menyentuh Bobot: Sistem harness modern sering meminta model berukuran besar untuk merangkum aksi masa lalu menjadi "skills" teks yang disimpan dalam file markdown/vektor database. Setiap kali inferensi dijalankan, ratusan baris prompt disuntikkan kembali ke konteks. Ini mahal secara finansial, menghabiskan window konteks yang berharga, dan yang terpenting: pengetahuan tidak pernah menjadi intuisi parametrik model. Jika skill tidak ter-retrieve dengan tepat, model kembali bodoh seketika.
2. Rekayasa X-Tree: Penambangan Deterministik Tanpa Panggilan LLM via Formulasi X-Score
Mengambil inspirasi dari algoritma tokenisasi teks klasik seperti Byte-Pair Encoding (BPE) dan WordPiece—yang membangun kosakata sub-kata murni dengan menghitung frekuensi pasangan karakter—peneliti merancang X-Tree. Namun berbeda dari teks biasa di mana kata tidak memiliki status keberhasilan, trajektori agen memiliki dimensi vital: panjang langkah dan sukses atau gagalnya misi.
Misalkan $u$ dan $v$ adalah dua simbol aksi yang bersebelahan dalam korpus (baik berupa aksi kanonikal primitif maupun node hierarki hasil merger sebelumnya). Kandidat gabungan dinotasikan $uv$. Frekuensi kemunculan bersebelahan dinotasikan $f_{uv}$, dan panjang primitif gabungan adalah $l_u + l_v$ (dengan $l=1$ untuk aksi primitif). Fraksi kemunculan pasangan dalam episode yang sukses dinotasikan $\text{succ}(uv)$.
Formulasi X-Score dirumuskan secara elegan sebagai:
Di mana parameter eksponen $p_l$ dan $p_s$ (default 1.0) mengatur bobot kepentingan panjang dan probabilitas sukses relatif terhadap frekuensi perulangan, serta $\epsilon$ adalah faktor smoothing Laplace. Dengan formulasi ini, sebuah sub-rutin yang panjang, berulang secara konsisten, dan terbukti menghasilkan kesuksesan akan selalu mengalahkan pasangan aksi yang sering muncul namun pendek atau rawan kegagalan.
Gerbang Kompresi Berbasis Teori Informasi (Compression Gate)
Sebuah merger tidak boleh sembarangan dieksekusi agar korpus tidak kolaps menjadi beberapa simbol raksasa yang kaku. Setiap merger mengeliminasi $(f_{uv} - 1)$ simbol dari korpus dengan biaya penambahan entri kamus sebesar $(l_u + l_v)$. X-Tree menetapkan aturan penghentian matematis:
Parameter $\eta$ (kompleksitas kompresi) mencegah overfitting. Hasil akhir dari proses penggabungan rekursif ini adalah pohon biner (X-Tree) di mana daun adalah aksi primitif, dan node internal adalah skill reusable dengan kedalaman hierarkis $d_v = 1 + max(d_u, d_w)$.
3. Tiga Mode Pelatihan X-Tree Langsung ke Bobot Model
Keunggulan sejati X-Tree bukan sekadar pada penambangan pohonnya, melainkan bagaimana struktur hierarki ini ditransformasikan menjadi sinyal pelatihan untuk mengoptimalkan bobot model $\pi_\theta$. Tim peneliti merumuskan tiga arsitektur integrasi komprehensif:
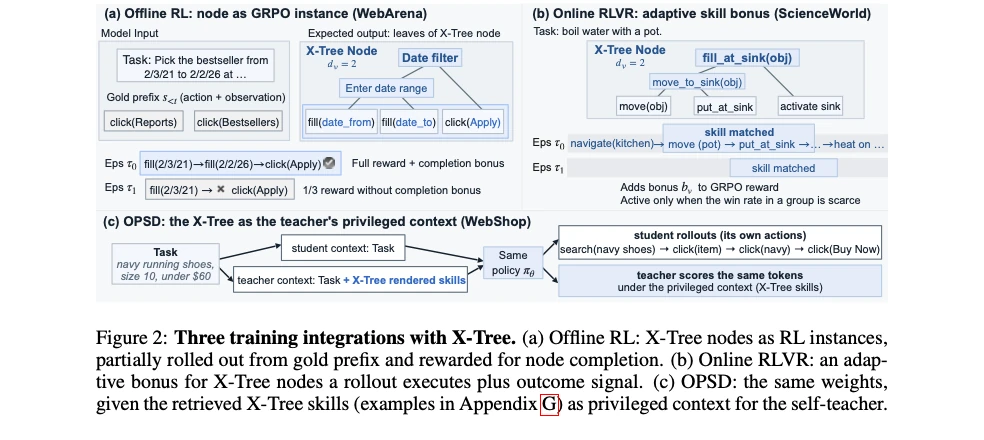
Offline RL: Node as RL Instance
Dalam dataset statis tanpa simulator live, setiap node X-Tree dijadikan instance pelatihan mandiri. Model dikondisikan pada observasi historis ($s_{
Online RLVR: Adaptive Skill Bonus
Pada awal RL, sparse reward sering membuat seluruh rollouts bernilai 0 sehingga gradien lenyap. X-Tree memberikan sinyal kontras berupa adaptive skill bonus ($b_v$). Bobot bonus $\lambda_g$ otomatis meluruh menjadi nol saat rasio kemenangan kelompok ($w_g$) mencapai threshold $w_{\text{ref}}$, menjamin kebijakan akhir murni diarahkan oleh verifier lingkungan.
OPSD: Privileged Self-Teacher
Model yang sama ($\pi_\theta$) bertindak ganda sebagai siswa dan guru. Siswa menghasilkan trajektori tanpa bantuan konteks. Guru membaca rollouts yang sama namun dengan konteks istimewa berupa skill X-Tree ter-retrieve. Melalui confidence gate $g_t = \sigma(\beta \delta_t)$, siswa dipandu secara presisi hanya pada token di mana guru memiliki keunggulan pengetahuan.
Persamaan Objektif Inti (arXiv:2609.32993 Eq. 2, 3, 4):
$$r = (1 - \alpha)\frac{1}{l_v}\sum_{j}\text{match}_j + \alpha(1 + \gamma d_v) c_v \quad [\alpha = 0.3, , \gamma = 0.5]$$
$$r_i = R_{\text{out}}(\tau_i) + \lambda_g \sum_{v in \text{matched}(\tau_i)} b_v, \quad \lambda_g = \lambda_0 \cdot \text{clip}\left(1 - \frac{w_g}{w_{\text{ref}}}, 0, 1\right)$$
$$\mathcal{L} = \mathcal{L}_{\text{GRPO}}(R_{\text{out}}) + \frac{c}{|y|}\sum_{t} g_t \cdot \left[log \pi_{\bar{\theta}}(y_t | s_{\text{tea}}) - log \pi_{\theta}(y_t | s_{\text{stu}})\right], \quad g_t = \sigma(\beta \delta_t)$$
4. Evaluasi Empiris Komprehensif: WebArena, ScienceWorld, dan WebShop
Evaluasi empiris dilakukan pada tiga tolak ukur agentik representatif dengan berbagai skala model (1.5B, 3B, dan 7B parameter). Seluruh baseline dijalankan pada harness, dataset, dan budget komputasi yang identik.
| Metodologi Pelatihan (Qwen2.5-7B) | GitLab (187) | Shopping (158) | Admin (156) | Reddit (112) | Map (67) | All 694 Tasks (SR %) |
|---|---|---|---|---|---|---|
| Qwen2.5-7B-Instruct Base (w/o RL) | 6.4% | 7.8% | 7.7% | 2.4% | 9.0% | 6.5% |
| Go-Browse (SFT-Full, 2 epochs) | 16.8% | 21.7% | 22.9% | 16.4% | 10.4% | 18.4% |
| Go-Browse (SFT-Full, 4 epochs compute match) | 17.5% | 19.4% | 24.4% | 16.1% | 13.4% | 18.8% |
| Offline RL w/ Outcome-only Reward | 15.5% | 23.4% | 23.1% | 15.2% | 7.5% | 18.2% |
| Offline RL w/ Random Spans | 18.4% | 20.9% | 26.6% | 14.7% | 11.9% | 19.5% |
| X-Tree Curriculum ($d_v = 1 \to 2 dots$) | 17.8% | 21.5% | 28.6% | 20.8% | 12.4% | 21.2% |
| X-Tree Full (Offline RL + Depth Bonus) | 22.0% | 26.6% | 29.3% | 18.8% | 10.4% | 22.9% |
Bukti Ilmiah: Mengapa Struktur Pohon Merupakan Faktor Penentu (Ablation Proof)
Tabel ablasi membuktikan bahwa keunggulan X-Tree tidak berasal dari segmentasi acak atau sekadar pelatihan bertahap:
- Whole Trajectory (Tanpa Pohon): Menggunakan algoritma RL yang sama namun pada seluruh trajektori menyebabkan SR merosot sebesar -3.0% (turun ke 19.9%).
- Random Span (Batas Acak): Menyamakan jumlah dan histogram panjang segmen namun memilih batas aksi secara acak menyebabkan penurunan -3.4% (turun ke 19.5%).
- Random Tree (Merger Acak Tanpa X-Score): Membangun pohon dengan jumlah merger yang sama persis namun memilih pasangan secara acak menyebabkan performa anjlok drastis -5.0% (turun ke 17.9%, lebih buruk daripada SFT dasar). Ini membuktikan secara mutlak bahwa fungsi X-Score berhasil menangkap sub-prosedur fungsional yang benar.
ScienceWorld (Generalization Folds)
Evaluasi tingkat generalisasi pada tiga fold independen (Zhang et al., 2025):
- • G0 (Seen Tasks, 1.6k): 7B meningkat dari 56.7% menjadi 61.6% (+4.9% SR)
- • G1 (Unseen Variations, 1.6k): 7B meningkat dari 50.2% menjadi 53.1% (+2.9% SR)
- • G2 (Unseen 10 Task Types): 7B meningkat dari 21.7% menjadi 25.6% (+3.9% SR)
Keberhasilan transfer pada tugas G2 yang sama sekali belum pernah dilihat membuktikan bahwa hierarki skill X-Tree membentuk pemahaman struktural abstrak, bukan sekadar menghafal rute aksi.
WebShop (E-Commerce Multi-Turn)
Evaluasi pada 1.824 trajektori interaktif belanja daring lintas skala model:
- • Model 1.5B: Success Rate 73.8% $\to$ 76.5% (+2.7%) | Graded 88.0% $\to$ 89.6% (+1.6%)
- • Model 3.0B: Success Rate 74.0% $\to$ 75.9% (+1.9%) | Graded 87.7% $\to$ 88.4% (+0.7%)
- • Model 7.0B: Success Rate 73.8% $\to$ 77.4% (+3.6%) | Graded 85.6% $\to$ 90.2% (+4.6%)
Gap performa melebar paling signifikan pada skala parameter terbesar (7B), mengindikasikan bahwa kapasitas representasi model yang lebih besar mampu menyerap hierarki komposisional X-Tree dengan efisiensi yang lebih tinggi.
5. Implementasi Produksi TypeScript: Tokenizer, Sinyal Kontras, dan OPSD Supervisor
Di bawah ini adalah implementasi end-to-end dalam TypeScript modern yang mendemonstrasikan algoritma penambangan deterministik XTreeTokenizer, pemeringkat XScore, sistem penyampelan XTreeOfflineRLSampler, dan controller adaptif untuk integrasi ke dalam pipeline pelatihan agen:
// Production Implementation: X-Tree Tokenizer, X-Score Recursive Merger & Multi-Mode Training Controller
// Berdasarkan Arsitektur Waterloo / Duke / NUS (arXiv:2609.32993 - Sitao Cheng et al., 2026)
//
// Karakteristik Inti:
// 1. Deterministic Tokenization: Zero LLM calls via X-Score = f_uv * (l_u + l_v)^p_l * (succ(uv) + eps)^p_s
// 2. Information-Theoretic Compression Gate: f_uv - 1 > eta * (l_u + l_v)
// 3. Offline RL Node Sampling: Depth-scaled node completion reward r = (1-alpha)*match_ratio + alpha*(1+gamma*d_v)*c_v
// 4. Online RLVR Adaptive Skill Bonus: r_i = R_out + lambda_g * sum(b_v) dengan annealing dinamis saat verifier aktif
// 5. OPSD Distillation Supervisor: Confidence-gated token distillation g_t = sigma(beta * delta_t)

export interface PrimitiveAction {
  id: string;
  actionType: 'click' | 'fill' | 'navigate' | 'select' | 'submit';
  targetElement: string;
  payload?: string;
  isCanonical: boolean;
}

export interface XTreeNode {
  nodeId: string;
  symbol: string;
  leftChild?: XTreeNode;
  rightChild?: XTreeNode;
  primitiveSequence: PrimitiveAction[];
  length: number;       // l_v: jumlah aksi primitif
  depth: number;        // d_v: kedalaman hierarki pohon
  frequency: number;    // f_uv: frekuensi kemunculan
  successRate: number;  // succ(uv): rasio kemunculan di episode sukses
  xScore: number;       // Skor merger akhir
}

export interface CandidateMerge {
  leftSymbol: string;
  rightSymbol: string;
  combinedSymbol: string;
  frequency: number;
  totalLength: number;
  successRate: number;
  xScore: number;
}

export class XTreeTokenizer {
  private vocabulary: Map = new Map();
  private compressionPenaltyEta: number = 0.5;
  private pLength: number = 1.0;
  private pSuccess: number = 1.0;
  private epsilonSmoothing: number = 0.05;

  constructor(options?: { eta?: number; pL?: number; pS?: number; eps?: number }) {
    if (options?.eta !== undefined) this.compressionPenaltyEta = options.eta;
    if (options?.pL !== undefined) this.pLength = options.pL;
    if (options?.pS !== undefined) this.pSuccess = options.pS;
    if (options?.eps !== undefined) this.epsilonSmoothing = options.eps;
  }

  /**
   * Menghitung X-Score untuk pasangan simbol adjasen:
   * X(u,v) = f_uv * (l_u + l_v)^p_l * (succ(uv) + eps)^p_s
   */
  public calculateXScore(frequency: number, totalLength: number, successRate: number): number {
    const recurrenceTerm = frequency;
    const lengthTerm = Math.pow(totalLength, this.pLength);
    const successTerm = Math.pow(successRate + this.epsilonSmoothing, this.pSuccess);
    return recurrenceTerm * lengthTerm * successTerm;
  }

  /**
   * Memeriksa gerbang kompresi: f_uv - 1 > eta * (l_u + l_v)
   */
  public satisfiesCompressionGate(frequency: number, totalLength: number): boolean {
    return (frequency - 1) > (this.compressionPenaltyEta * totalLength);
  }

  /**
   * Melakukan recursive merging deterministik tanpa panggilan LLM
   */
  public mineXTree(
    trajectories: Array<{ actions: PrimitiveAction[]; isSuccessful: boolean }>,
    maxMerges: number = 256
  ): Map {
    // 1. Inisialisasi kosakata dengan aksi primitif kanonikal (l=1, depth=0)
    for (const traj of trajectories) {
      for (const act of traj.actions) {
        const canonicalKey = `${act.actionType}<${act.targetElement}>`;
        if (!this.vocabulary.has(canonicalKey)) {
          this.vocabulary.set(canonicalKey, {
            nodeId: `node-${nanoid(6)}`,
            symbol: canonicalKey,
            primitiveSequence: [act],
            length: 1,
            depth: 0,
            frequency: 1,
            successRate: traj.isSuccessful ? 1.0 : 0.0,
            xScore: 0,
          });
        }
      }
    }

    // 2. Iterative Pair Mining Loop
    let mergeCount = 0;
    while (mergeCount < maxMerges) {
      const pairStats = new Map();

      // Scanning n-gram pasangan bersebelahan di seluruh korpus
      for (const traj of trajectories) {
        const symbols = traj.actions.map(a => `${a.actionType}<${a.targetElement}>`);
        for (let i = 0; i < symbols.length - 1; i++) {
          const u = symbols[i];
          const v = symbols[i + 1];
          const pairKey = `${u}__+__${v}`;
          const entry = pairStats.get(pairKey) || { count: 0, successCount: 0, left: u, right: v };
          entry.count += 1;
          if (traj.isSuccessful) entry.successCount += 1;
          pairStats.set(pairKey, entry);
        }
      }

      // Evaluasi kandidat merger terbaik berdasarkan X-Score
      let bestCandidate: CandidateMerge | null = null;
      for (const [key, stats] of pairStats.entries()) {
        const leftNode = this.vocabulary.get(stats.left);
        const rightNode = this.vocabulary.get(stats.right);
        if (!leftNode || !rightNode) continue;

        const totalLength = leftNode.length + rightNode.length;
        if (!this.satisfiesCompressionGate(stats.count, totalLength)) continue;

        const successRate = stats.count > 0 ? stats.successCount / stats.count : 0;
        const score = this.calculateXScore(stats.count, totalLength, successRate);

        if (!bestCandidate || score > bestCandidate.xScore) {
          bestCandidate = {
            leftSymbol: stats.left,
            rightSymbol: stats.right,
            combinedSymbol: `(${stats.left} -> ${stats.right})`,
            frequency: stats.count,
            totalLength,
            successRate,
            xScore: score,
          };
        }
      }

      // Berhenti jika tidak ada pasangan yang memenuhi kriteria kompresi
      if (!bestCandidate) break;

      // Bentuk node hierarki baru
      const leftChild = this.vocabulary.get(bestCandidate.leftSymbol)!;
      const rightChild = this.vocabulary.get(bestCandidate.rightSymbol)!;
      const newNode: XTreeNode = {
        nodeId: `xtree-${nanoid(6)}`,
        symbol: bestCandidate.combinedSymbol,
        leftChild,
        rightChild,
        primitiveSequence: [...leftChild.primitiveSequence, ...rightChild.primitiveSequence],
        length: bestCandidate.totalLength,
        depth: 1 + Math.max(leftChild.depth, rightChild.depth),
        frequency: bestCandidate.frequency,
        successRate: bestCandidate.successRate,
        xScore: bestCandidate.xScore,
      };

      this.vocabulary.set(bestCandidate.combinedSymbol, newNode);
      mergeCount += 1;
    }

    return this.vocabulary;
  }
}

/**
 * Controller 1: Offline RL Instance Sampler & Reward Evaluator (WebArena)
 * Mengubah node internal X-Tree menjadi unit latihan GRPO parsial dengan step matching & completion bonus
 */
export class XTreeOfflineRLSampler {
  private alpha: number = 0.3;
  private gamma: number = 0.5;

  constructor(alpha: number = 0.3, gamma: number = 0.5) {
    this.alpha = alpha;
    this.gamma = gamma;
  }

  public evaluateRolloutReward(
    goldActions: PrimitiveAction[],
    rolloutActions: PrimitiveAction[],
    nodeDepth: number
  ): { reward: number; isCompleted: boolean; stepMatchRatio: number } {
    const nodeLength = goldActions.length;
    let matchCount = 0;
    let perfectContinuousMatch = true;

    for (let j = 0; j < nodeLength; j++) {
      if (j >= rolloutActions.length) {
        perfectContinuousMatch = false;
        break;
      }
      const isStepMatch =
        goldActions[j].actionType === rolloutActions[j].actionType &&
        goldActions[j].targetElement === rolloutActions[j].targetElement;

      if (isStepMatch && perfectContinuousMatch) {
        matchCount += 1;
      } else {
        perfectContinuousMatch = false;
        break; // Rollout berhenti saat match_j = 0
      }
    }

    const stepMatchRatio = nodeLength > 0 ? matchCount / nodeLength : 0;
    const isCompleted = matchCount === nodeLength;
    const depthFactor = 1.0 + (this.gamma * nodeDepth);

    // Formulasi Reward Eq. 2 (arXiv:2609.32993)
    // r = (1 - alpha) * (1 / l_v) * sum(match_j) + alpha * (1 + gamma * d_v) * c_v
    const reward = ((1 - this.alpha) * stepMatchRatio) + (this.alpha * depthFactor * (isCompleted ? 1.0 : 0.0));

    return { reward, isCompleted, stepMatchRatio };
  }
}

/**
 * Controller 2: Online RLVR Adaptive Skill Bonus (ScienceWorld & WebShop)
 * Menginjeksi kontras pada sparse reward dan otomatis meluruh (annealing) saat verifier aktif
 */
export class XTreeOnlineRLVRBonus {
  private lambda0: number = 0.75;
  private wRef: number = 0.4; // Threshold saturasi verifier (ScienceWorld=0.4, WebShop=0.85)

  constructor(lambda0: number = 0.75, wRef: number = 0.4) {
    this.lambda0 = lambda0;
    this.wRef = wRef;
  }

  public calculateAdaptiveWeight(groupSuccessRate: number): number {
    const rawRatio = 1.0 - (groupSuccessRate / this.wRef);
    const clipped = Math.max(0, Math.min(1.0, rawRatio));
    return this.lambda0 * clipped;
  }

  public computeTotalReward(
    verifierOutcomeReward: number,
    matchedSkillNodes: XTreeNode[],
    groupSuccessRate: number
  ): { totalReward: number; skillBonus: number; adaptiveLambda: number } {
    const lambdaG = this.calculateAdaptiveWeight(groupSuccessRate);
    const skillBonusSum = matchedSkillNodes.reduce((acc, node) => acc + (1.0 + 0.5 * node.depth), 0);
    const skillBonus = lambdaG * skillBonusSum;
    const totalReward = verifierOutcomeReward + skillBonus;

    return { totalReward, skillBonus, adaptiveLambda: lambdaG };
  }
}

/**
 * Controller 3: On-Policy Self-Distillation (OPSD) Supervisor
 * Guru dan siswa adalah model yang sama (pi_theta), guru menerima X-Tree skills terindeks sebagai privileged context
 */
export class XTreeOPSDSupervisor {
  private beta: number = 2.0;       // Sharpness confidence gate
  private distillationWeight: number = 0.01;

  public computePerTokenGuidance(
    teacherLogProb: number,
    studentLogProb: number
  ): { deltaT: number; gateWeight: number; lossContribution: number } {
    const deltaT = teacherLogProb - studentLogProb;
    // Logistic sigmoid gate: g_t = sigma(beta * delta_t)
    const gateWeight = 1.0 / (1.0 + Math.exp(-this.beta * deltaT));
    const lossContribution = this.distillationWeight * gateWeight * deltaT;

    return { deltaT, gateWeight, lossContribution };
  }
}
6. Kesimpulan & Implikasi Desain untuk Enterprise AI Engineering
Kehadiran X-Tree menandai titik balik penting dalam evolusi sistem agen otonom:
- Eliminasi Total Overhead Ekstraksi LLM: Ekstraksi skill library tidak lagi memerlukan jutaan token panggilan model komersial tertutup yang lambat dan mahal. Tokenisasi berbasis statistik frekuensi dan kompresi information-theoretic mampu mengekstrak rutinitas aksi yang jauh lebih bersih, deterministik, dan dapat diaudit (auditable).
- Transisi dari In-Context Advice ke Parametric Competence: Alih-alih membebani prompt inference dengan aturan instruksional yang rapuh, hierarki sub-rutin disuntikkan langsung ke dalam bobot model melalui varian RL (GRPO dengan depth factor dan adaptive contrast bonus). Agen bertindak dengan intuisi alamiah, bukan karena terus-menerus membaca contekan prompt.
- Skalabilitas Komputasi Pelatihan: Dengan mendekomposisi trajektori panjang menjadi instance node X-Tree terisolasi, runtime pelatihan seperti vLLM atau VeRL dapat memparalelkan rollout dan backpropagation secara masif dengan horizon langkah yang lebih ringkas, mengeliminasi bottleneck memori GPU pada sequence length ekstrim.
Referensi & Sumber Terverifikasi
- [1]X-Tree: Tokenizing Reusable Experience for Efficient Agent Generalization(arXiv:2609.32993v1 [cs.AI / cs.LG] — Sitao Cheng, Xunjian Yin, Zhiyuan Sun, Yuxuan Li, Ruiwen Zhou, Xiangru Jian, Victor Zhong (University of Waterloo, Duke University, NUS))
- [2]Go-Browse: Training Web Agents with Structured Exploration and Verification(arXiv:2506.03533 — Apurva Gandhi & Graham Neubig (Carnegie Mellon University))
- [3]WebArena: A Realistic Web Environment for Building Autonomous Agents(ICLR / arXiv:2307.13854 — Shuyan Zhou, Frank F. Xu, Hao Zhu, Xuhui Zhou, Robert Lo, Graham Neubig et al. (CMU))
- [4]DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models (GRPO Formulation)(arXiv:2402.03300 — Zhihong Shao, Peiyi Wang, Qihao Zhu, Runxin Xu, Junxiao Song, Xiao Bi et al. (DeepSeek-AI))
- [5]ScienceWorld: Is Language Enough for Simulating Interactive Environments?(EMNLP / arXiv:2203.07540 — Ruoyao Wang, Peter Jansen, Marc-Alexandre Côté, Prithviraj Ammanabrolu (Allen Institute for AI))
- [6]WebShop: Towards Scalable Real-World Web Interaction with Grounded Language Agents(NeurIPS / arXiv:2207.01206 — Shunyu Yao, Howard Chen, John Yang, Karthik Narasimhan (Princeton University))
Butuh Arsitektur Web & AI Berkualitas Tinggi?
Tim engineering NEWSAINT siap membantu merancang website berkecepatan tinggi, sistem AI autonomous, dan solusi SaaS terukur untuk bisnis Anda.
Artikel Terkait Lainnya

DecisionRAG (arXiv:2610.35868): Retriever-Free Retrieval via Decision Models — Eliminasi Capability Asymmetry, Hierarchical Tree Navigation, dan Rekor +17.4% Hit@1 Tanpa Indeks Vektor
Analisis arsitektur DecisionRAG (arXiv:2610.35868, Chao Wan, Paul Jünger, Beixi Du, Bodong Liu, Navaneetha Krishnan, Kilian Q. Weinberger — Cornell University & ASAPP): Mengapa retrieval konvensional (BM25, dense embeddings) menciptakan capability asymmetry terhadap LLM generator modern, dan bagaimana DecisionRAG menavigasi struktur korpus bertingkat menggunakan model keputusan (decision models) dalam konteks bersama (shared context) tanpa token generasi, menghasilkan lompatan +13.8 R@1 di MultiDoc2Dial, +17.4 Hit@1 di Natural Questions, dan latensi secepat 0.68 detik.

DynaFlow (arXiv:2610.34467): Free-Form Multi-Agent Orchestration — Sintesis Alur Kerja Eksekutabel, Eliminasi Defek Aliran Informasi, dan Lonjakan Akurasi 88.08% Tanpa Mengubah Bobot Sub-Agent
Analisis arsitektur DynaFlow (arXiv:2610.34467, Ruhao Liu et al., NUS): Mengapa topologi multi-agent statis memicu overhead komunikasi berlebihan, dan bagaimana integrasi sintesis alur kerja bebas ke dalam ruang aksi Main Agent — dikombinasikan dengan Two-Stage SFT dan kurasi 3 defek orkestrasi — menghasilkan akurasi 88.08% serta memecahkan 100% soal AIME dengan sub-agent berbobot beku.

Code Graphs & Embeddings pada Small Coding Agents (arXiv:2610.33958): Eksperimen 79k Episode SWE-bench, Gradien Hop Depth, dan Batasan Representasi Leksikal Satu-Langkah
Analisis empiris 79k episode SWE-bench Verified (arXiv:2610.33958, Saurav Bellam): Apakah tool knowledge graph dan embedding search benar-benar melengkapi pemahaman struktural coding agent kecil? Menyingkap degradasi hop gradient (odds ratio 0.50–0.67 per hop), anomali tool uptake pada model 32B, dan bukti linear probing bahwa representasi kode internal agen open-weight masih dominan bersifat leksikal satu-langkah.