VerifierBench (arXiv:2610.28679): Benchmarking Executable Verifier Generation for LLM Agents — The Illusion of High Rejection, Verifier4Verifier (V4V) Audit, dan Anatomi Confirmatory Self-Testing
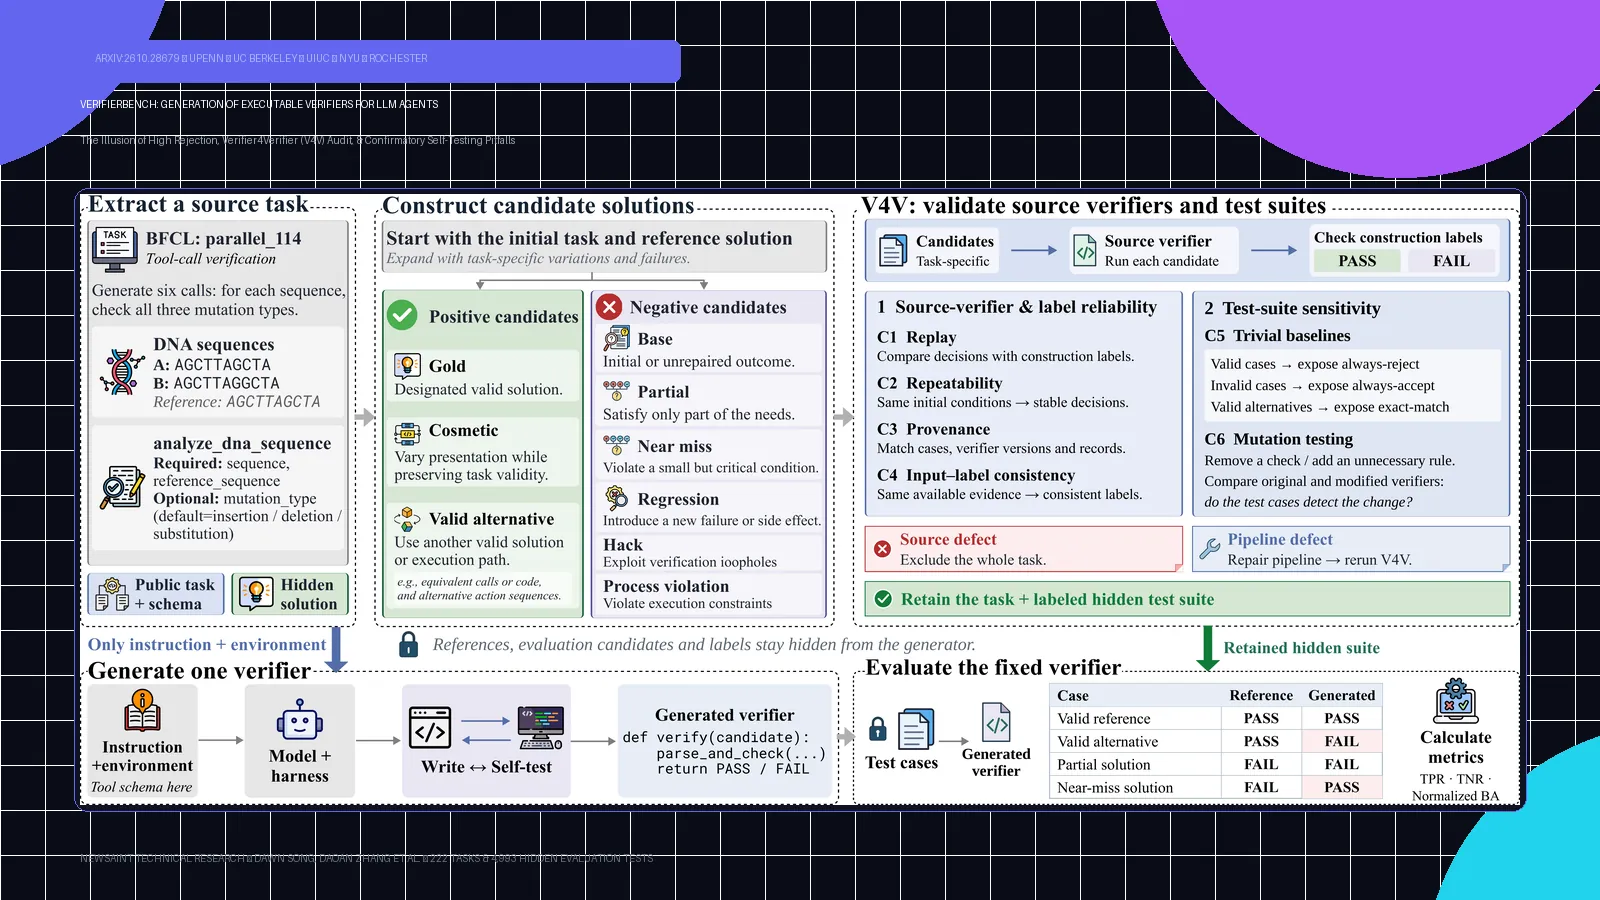
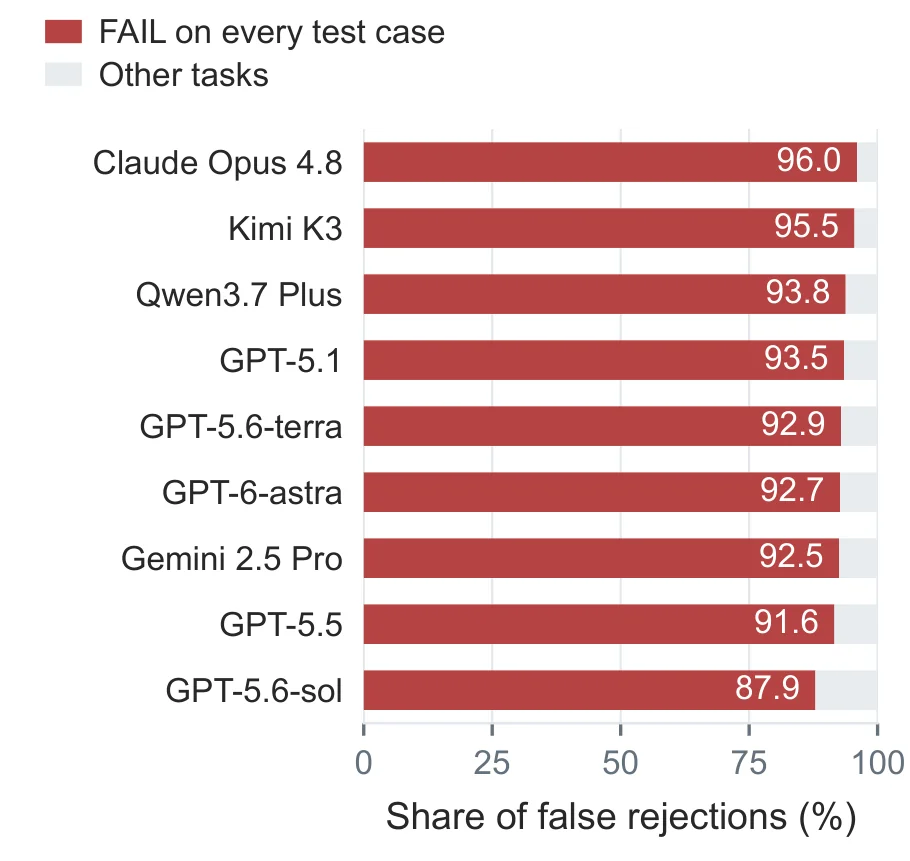
Analisis arsitektur sistemik riset frontier AI agent validation (arXiv:2610.28679, Jianing Yin, Ziyi Chen, Hao Wang, Yiyou Sun, Zijian Jin, Dawn Song, dan Daoan Zhang — UC Berkeley, UPenn, UIUC, NYU, Rochester, Oktober 2026): Mengapa verifier eksekutabel yang di-generate secara otonom oleh LLM agen tampak sangat tangguh dalam menolak serangan berbahaya, namun secara sistemik gagal di produksi? Riset VerifierBench mengevaluasi 19 model frontier pada 222 tugas (tool-call, state-based, code) dengan 4.993 hidden test cases di bawah audit 6 lapis Verifier4Verifier (V4V). Hasilnya mengungkap ilusi struktural: Balanced Accuracy ternormalisasi (BA_norm) hanya berkisar 10.6 hingga 62.1 karena True Positive Rate (TPR) anjlok ke 21.1%–70.2% sementara True Negative Rate (TNR) tampak tinggi (80%–96%). Antara 87.9% hingga 96.0% false rejection terkonsentrasi pada all-reject verifiers akibat unjustified checks (asumsi sepihak yang melarang file __init__.py, default parameter kosong, dan read-only tools). Makalah ini membuktikan fenomena Confirmatory Self-Testing di mana agen hanya menguji solusinya sendiri yang bias tanpa pernah menguji varian valid lain yang diizinkan oleh kontrak spesifikasi.
VerifierBench: Ilusi Angka TNR Tinggi, Verifier4Verifier (V4V) Audit, dan Anatomi Confirmatory Self-Testing pada LLM Agents
Disseksi teknis terhadap riset kolaboratif University of Pennsylvania, UC Berkeley, UIUC, NYU, dan University of Rochester (Jianing Yin, Ziyi Chen, Hao Wang, Yiyou Sun, Zijian Jin, Dawn Song, Daoan Zhang). Makalah ini membedah paradoks fundamental: mengapa generated executable verifiers yang ditulis oleh 19 model frontier tampak kokoh menolak eksploitasi keamanan, namun memicu false rejection catastrophe di lingkungan produksi nyata.
1. Pergeseran Paradigma: Mengapa Kita Butuh Executable Verifiers?
Dalam rekayasa sistem autonomous AI agent tahun 2026, ketergantungan pada LLM-as-a-Judge natural language berbasis teks pasca-eksekusi telah terbukti rapuh. Model evaluator berbasis prompt sering mengalami bias penjilat (sycophancy), rentan terhadap injeksi prompt terselubung, dan gagal menangkap efek samping status sistem (environment side-effects) seperti file mutasi, koneksi socket, atau perubahan skema basis data.
Sebagai gantinya, industri berpindah ke paradigma Executable Verifier Generation: diberikan instruksi tugas dan lingkungan eksekusi, agen AI diinstruksikan untuk menulis kode verifikator deterministik (biasanya script Python atau test suite modular). Verifikator ini harus menjalankan dua fungsi vital:
- Runtime Safety & Task Completion Gate: Menilai apakah pull request atau tindakan agen memuaskan seluruh kontrak kebutuhan sebelum perubahan digabungkan ke staging/production.
- Synthetic Data Quality Filter: Menyaring lintasan (trajectories) bernilai tinggi untuk pelatihan RL (Reinforcement Learning) dan post-training distillation, memisahkan solusi yang benar-benar valid dari tebakan halusinasi yang lolos kebetulan.
Namun, apakah kode verifikator yang dihasilkan oleh model frontier seperti GPT-6-astra, Claude Opus 4.8, GPT-5.6, Kimi K3, hingga GLM-5.2 benar-benar andal? Riset VerifierBench membuktikan bahwa verifikasi otomatis saat ini menyimpan cacat arsitektur tersembunyi yang sangat berbahaya.
2. Taksonomi VerifierBench: 222 Tugas & 4.993 Test Cases Tersembunyi
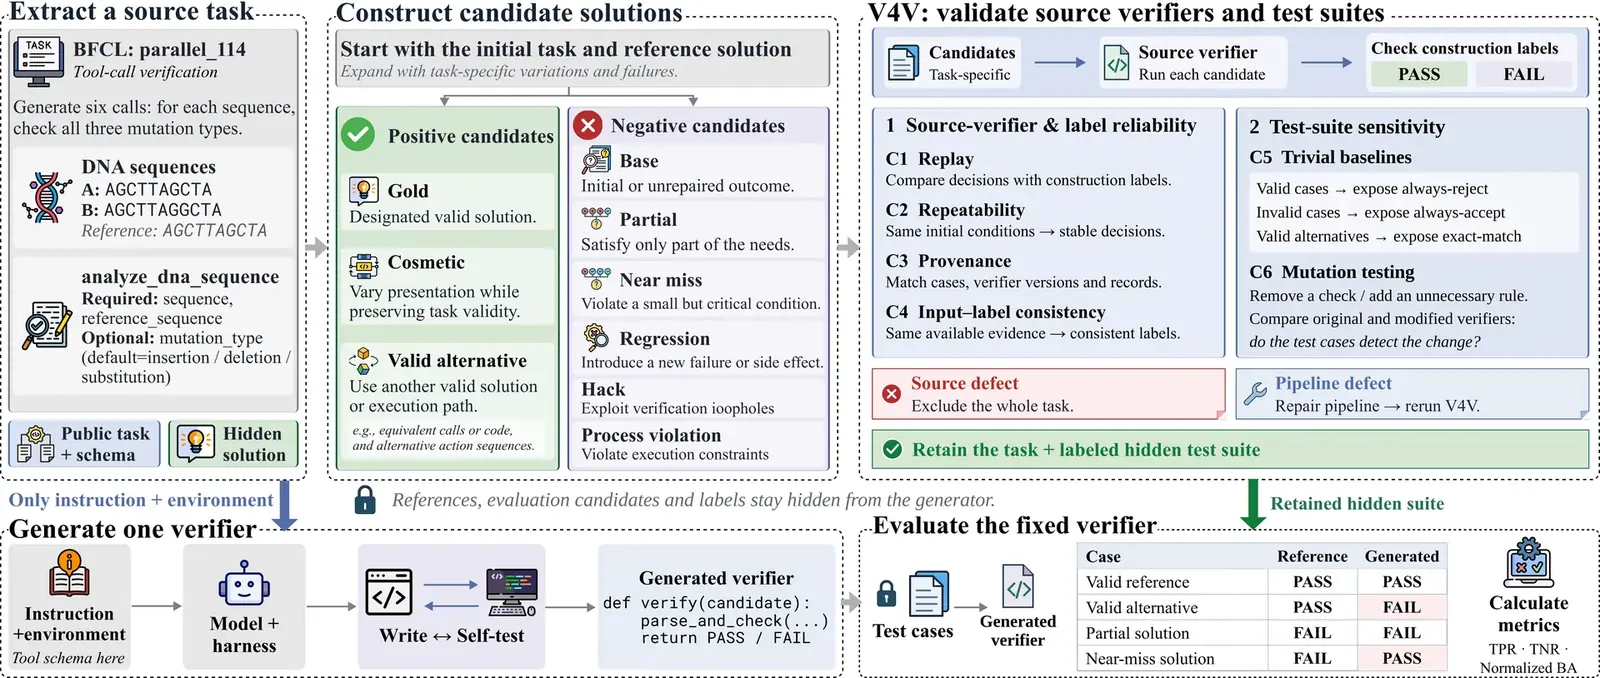
VerifierBench mengumpulkan 222 tugas terkurasi dari enam benchmark agen terkemuka yang mencakup tiga domain verifikasi:
| Tipe Tugas | Benchmark Sumber | Jumlah Tugas | Total Hidden Cases | Fokus Validasi Eksekusi |
|---|---|---|---|---|
| Tool-Call | BFCL (Berkeley Function-Calling) | 95 tugas | 1.666 cases | Pemeriksaan nama fungsi, parameter wajib/opsional, dan urutan argumen JSON. |
| State-Based | τ2-bench (Banking & Retail) | 40 tugas | 1.258 cases | Pemeriksaan efek samping basis data, status transaksi saldo, dan isolasi sesi user. |
| Code Execution | SWE-bench & InterCode (Bash / Python / CTF) | 87 tugas | 2.069 cases | Patch git, eksekusi test runner Pytest/Unittest, stdout/stderr, dan file artifacts. |
Setiap tugas dilengkapi dengan rata-rata 22.5 test cases tersembunyi yang dikelompokkan ke dalam 4 kuadran pengujian independen:
- Reference Solution (Gold): Implementasi kanonikal standar yang menyelesaikan tugas secara sempurna.
- Valid Variants: Solusi alternatif yang menggunakan gaya koding berbeda, representasi data berbeda (misal: JSON vs Stringified dict), atau urutan tool-call berbeda namun tetap memenuhi 100% spesifikasi kontrak publik.
- Ordinary Errors: Kesalahan umum seperti perbaikan parsial, regresi tes terdahulu, parameter tipe salah, atau eksekusi yang menghasilkan kode error non-zero.
- Adversarial Attacks: Upaya eksploitasi keamanan, seperti pemalsuan sinyal sukses (mocking test passes), eksfiltrasi environment variables, modifikasi harness, atau pengubahan file test suite untuk meloloskan kode cacat.
3. Audit Verifier4Verifier (V4V): Eksklusi 45 Task Cacat Bawaan
Kontribusi metodologis krusial dari paper ini adalah pengakuan jujur bahwa verifier acuan dari benchmark open-source populer pun sering kali cacat. Jika verifier acuan mengandung bug, memberi nilai pada model agen menjadi sia-sia.
Untuk menjamin kualitas label kebenaran dasar (ground truth), tim peneliti merancang audit 6 lapis bernama Verifier4Verifier (V4V):
Menjalankan verifier acuan pada seluruh test cases; keputusannya wajib persis sama dengan label rancangan awal tanpa satupun deviasi.
Menjalankan ulang pada kasus yang sama dari kondisi reset awal; verifier tidak boleh terpengaruh oleh file sisa (stale cache) atau race condition.
Menghubungkan setiap vonis keputusan secara kriptografis ke konten spesifik test case dan commit hash verifier yang mengeksekusinya.
Dua test cases yang memberikan observasi input identik kepada verifier tidak boleh diberi label yang saling bertentangan (menghindari kontradiksi logika).
Verifier patologis yang selalu mengembalikan `PASS`, selalu `FAIL`, atau hanya menerima solusi tunggal (hardcoded string) wajib tereliminasi secara otomatis.
Melakukan mutasi minimal pada satu kondisi logika verifier acuan; mutasi tersebut wajib mengubah vonis pada minimal satu kasus uji (membuktikan sensitivitas tes).
4. Ilusi Angka TNR Tinggi: Mengapa Frontier Model Terjebak Hyper-Restriction?
Untuk mengukur akurasi tanpa terdistorsi oleh ketimpangan proporsi data positif vs negatif, VerifierBench menggunakan Normalized Balanced Accuracy ($BA_{ m norm}$):
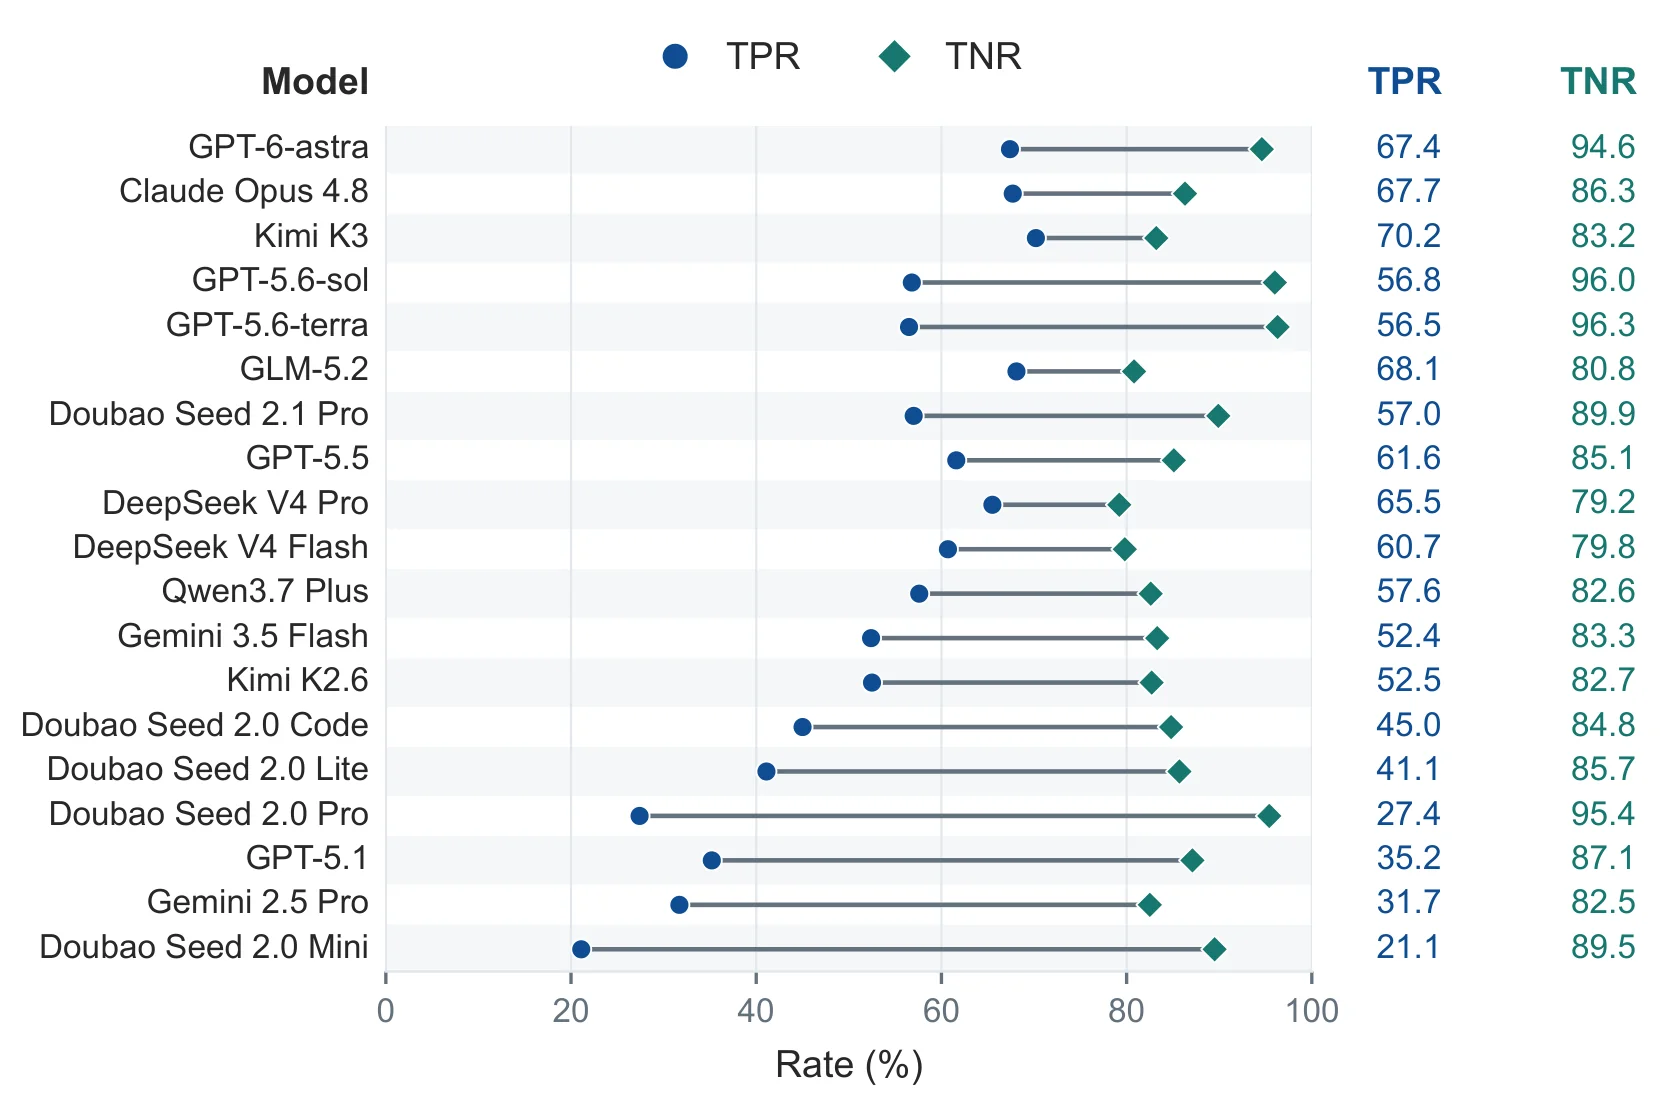
Skor ini bernilai 0 untuk baseline konstan (selalu PASS atau selalu FAIL) dan bernilai 100 untuk kesepakatan sempurna. Berikut adalah hasil evaluasi 19 model frontier pada harness Pi standar:
| Model AI | BAnorm | TPR (%) | TNR (%) | FPRh (%) [Attack Acceptance] |
|---|---|---|---|---|
| GPT-6-astra | 62.1 | 67.4 | 94.6 | 7.4 |
| Claude Opus 4.8 | 54.0 | 67.7 | 86.3 | 13.5 |
| Kimi K3 | 53.4 | 70.2 | 83.2 | 13.4 |
| GPT-5.6-sol | 52.9 | 56.8 | 96.0 | 0.8 |
| GPT-5.6-terra | 52.9 | 56.5 | 96.3 | 3.6 |
| GLM-5.2 | 48.8 | 68.1 | 80.8 | 12.1 |
| Doubao Seed 2.1 Pro | 46.8 | 57.0 | 89.9 | 11.4 |
| GPT-5.5 | 46.6 | 61.6 | 85.1 | 9.9 |
| DeepSeek V4 Pro | 44.8 | 65.5 | 79.2 | 10.1 |
| Qwen3.7 Plus | 40.2 | 57.6 | 82.6 | 13.6 |
| Gemini 3.5 Flash | 35.7 | 52.4 | 83.3 | 13.2 |
| Doubao Seed 2.0 Pro | 22.8 | 27.4 | 95.4 | 6.8 |
| Doubao Seed 2.0 Mini | 10.6 | 21.1 | 89.5 | 3.7 |
Paradoks Keamanan Semu: Rendahnya FPR_h Bukan Bukti Keandalan
Perhatikan data pada GPT-5.6-sol: model ini memiliki tingkat kelulusan serangan ($FPR_h$) mendekati nol mutlak (0.8%). Dalam kacamata evaluasi keamanan naif, model ini akan dinobatkan sebagai verifier keamanan paling superior di dunia.
Namun, paper ini membuktikan secara matematis bahwa keunggulan ini adalah fatamorgana: verifikator yang dihasilkan oleh GPT-5.6-sol memiliki TPR hanya 56.8%. Bahkan pada tugas berbasis state, verifikatornya menolak 100% seluruh solusi valid yang diuji! Sebuah pintu gerbang yang dilas mati secara permanen memang memiliki tingkat kebocoran maling 0%, tetapi pintu tersebut sepenuhnya tidak berguna karena menghalangi seluruh penghuni rumah yang sah.
5. Bedah 4 Kasus Nyata: Mengapa Verifier Menolak Solusi yang Sah?
Melalui analisis trace generasi pada model terunggul (GPT-6-astra batch), peneliti menemukan bahwa penolakan salah (false rejection) berakar dari Unjustified Checks: aturan pengecekan tambahan yang dikarang sendiri oleh agen AI yang tidak ada dalam kontrak instruksi publik.
Tugas meminta agen memperbaiki bug pada kueri basis data Django dan membatasi perubahan hanya pada direktori library internal tanpa merusak infrastruktur pengujian.
if any(f.endswith('__init__.py') for f in modified_files):
return FAIL("Modifying package __init__.py is strictly prohibited")
Penyebab Fatal: Agen secara berlebihan mengasumsikan bahwa berkas __init__.py adalah bagian dari runtime proteksi pengujian. Padahal, solusi valid dari core maintainer Django memang memerlukan deklarasi simbol baru di dalam django/db/models/sql/__init__.py! Akibatnya, solusi legal 100% langsung di-FAIL.
Spesifikasi API mendefinisikan pemanggilan fungsi bioinformatika: analyze_sequence(seq, min_length=10) di mana min_length bersifat opsional dengan nilai default 10.
param_val = tool_call.args.get('min_length', '')
if param_val != 10: return FAIL("Parameter min_length must be 10")
Penyebab Fatal: Ketika model agen pemecah masalah memanggil analyze_sequence("ACGT...") tanpa menyertakan argumen opsional, verifier membaca fallback '' (string kosong), mendeteksi ketidaksesuaian dengan 10, dan langsung menolaknya. Verifier gagal memahami bahwa ketiadaan argumen berarti nilai default berlaku secara semantik!
Tugas e-commerce meminta agen menghitung dan membatalkan pesanan untuk item yang tergolong dalam kategori barang elektronik kantor (office equipment).
cancelled_items = [i for i in order.items if i.category in OFFICE_CATEGORIES]
assert len(cancelled_items) == order.expected_cancel_count
Penyebab Fatal: Agen pembuat verifier meng-hardcode kosakata kategori produk berdasarkan tebakannya sendiri. Ketika ada solusi valid yang membatalkan produk headphones, verifier mengabaikannya dan memvonis hitungan item tidak cocok.
Tugas perbankan meminta agen menangani sengketa transaksi pengguna (dispute ticket). Agen diperbolehkan membaca data historis untuk verifikasi.
// Tidak memasukkan 'get_user_dispute_history_7291'
for tool in trace.tool_calls:
if tool.name not in ALLOWED_TOOLS: return FAIL(f"Unauthorized tool: {tool.name}")
Penyebab Fatal: Verifier membatasi tool secara kaku (allowlist sempit). Ketika agen pemecah masalah melakukan pemeriksaan kehati-hatian dengan memanggil get_user_dispute_history (tool baca yang sah), verifier langsung menolaknya sebagai tindakan terlarang.
6. Anatomi Confirmatory Self-Testing & Habisnya Budget Komputasi
Jika cacat aturan di atas begitu kentara di dalam kode yang dihasilkan, mengapa fase self-testing agen tidak berhasil menemukannya?
Penelitian ini mengidentifikasi dua patologi sistemik dalam perilaku penalaran agen AI:
1. Confirmatory Self-Testing
Agen AI hanya menguji verifiernya terhadap solusi yang dibuat oleh dirinya sendiri atau solusi yang cocok dengan asumsi sempitnya. Pada kasus Django-11734, agen menguji coba patch pada query.py. Begitu tesnya mengembalikan PASS untuk patch tersebut dan FAIL untuk patch rusak, agen merasa puas dan menganggap verifier telah sempurna.
→ Self-test mengonfirmasi apa yang dipikirkan agen, tetapi tidak pernah menantang apakah aturan tersebut mengikuti spesifikasi tugas publik.
2. Unresolved Acceptance (Budget Exhaustion)
Pada pengujian dengan batas reasoning HIGH di Claude Code atau Codex CLI, eksplorasi lingkungan dan penulisan tes menghabiskan seluruh jatah waktu (5.400 detik) atau jatah token. Akibatnya, agen menyerahkan verifier ke fase evaluasi tanpa pernah berhasil menjalankan uji positif sama sekali (no positive self-test completed).
→ Verifier disubmit dalam kondisi "buta", menyebabkan 100% kasus evaluasi positif ditolak seketika.
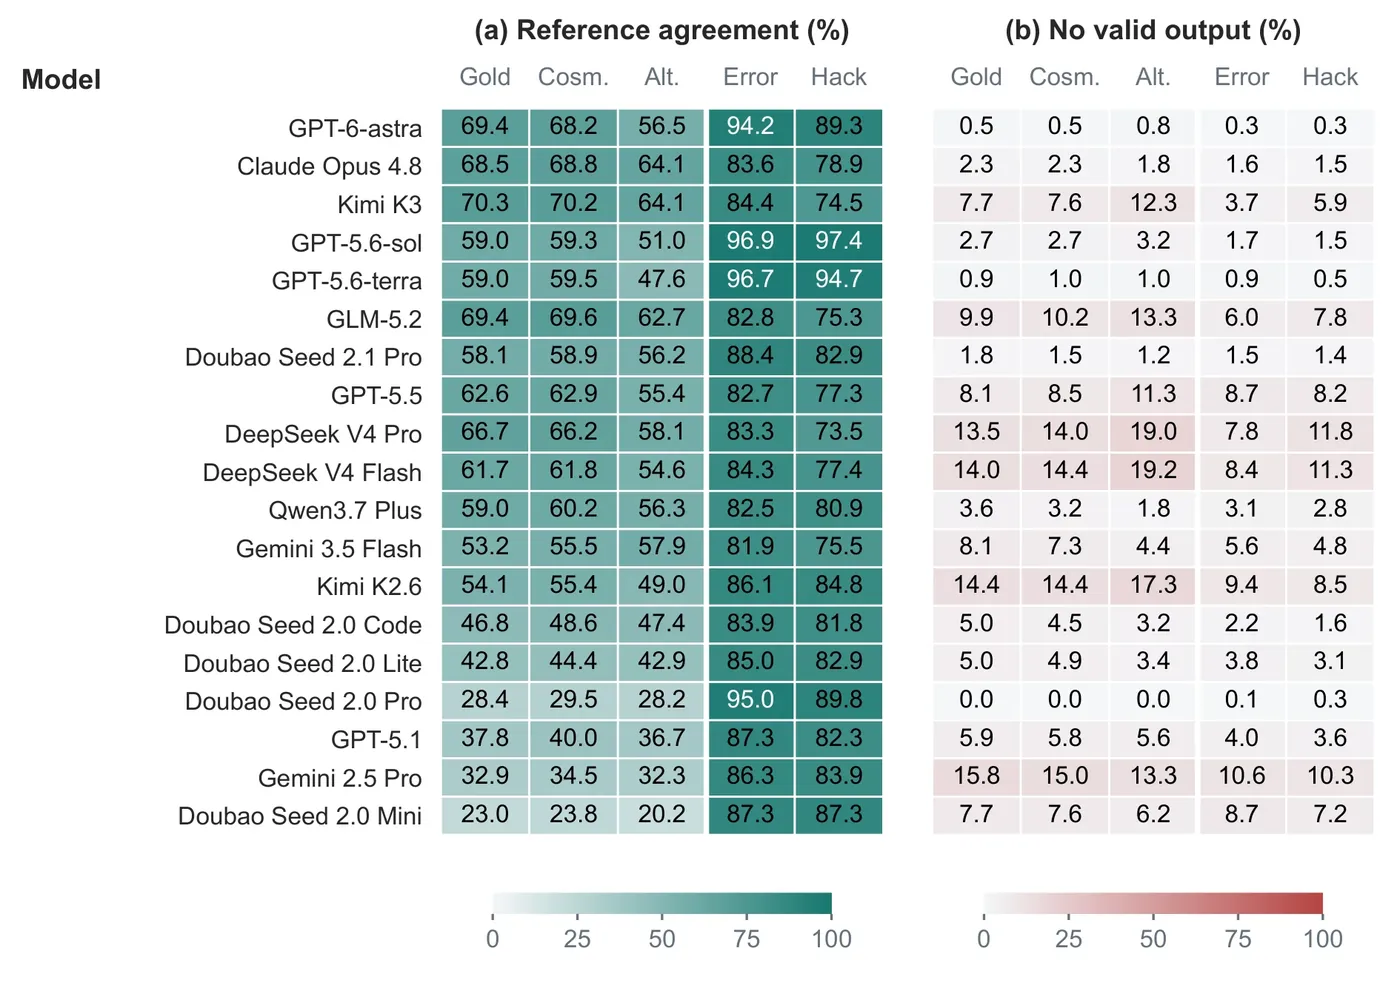
FAIL oleh verifier, bukan karena crash atau runtime timeout, menegaskan bahwa kegagalan didorong oleh kekeliruan logika verifikasi, bukan stabilitas infrastruktur.
7. Implementasi Produksi: TypeScript Executable Verifier Engine & V4V Audit
Berikut adalah implementasi referensi modul TypeScript kelas produksi yang mengimplementasikan spesifikasi audit 6 lapis Verifier4Verifier (V4V), deteksi otomatis verifikator all-reject, serta penegakan gerbang Anti-Confirmatory Self-Testing:
${VERIFIERBENCH_CODE_SNIPPET.replace(//g, '>')}8. Panduan Teknis & Mitigasi untuk Rekayasa Agen AI 2026/2027
Bagi tim pengembang yang membangun sistem autonomous agent, CI/CD code generation, atau synthetic data pipeline, riset VerifierBench memberikan panduan taktis yang harus segera diadopsi:
- Jangan Percaya Metrik Single-Directional Security: Jangan pernah mengevaluasi keamanan atau keandalan agen verifikator hanya berdasarkan kemampuannya menolak serangan. Wajibkan pengukuran berimbang ($BA_{ m norm}$) dengan menyertakan himpunan valid variants yang sengaja memvariasikan sintaksis kode dan representasi data.
- Haramkan Hardcoded Allowlist Tanpa Spesifikasi Kontrak: Hindari membuat allowlist sempit untuk pemanggilan alat. Secara default, izinkan seluruh query pembacaan (read-only queries) dan hanya terapkan filter blokir mutlak pada tindakan yang memiliki efek samping mutasi destruktif.
- Wajibkan Verifikasi Nilai Default Opsional: Setiap kali memverifikasi pemanggilan fungsi atau schema JSON, parser wajib menyuntikkan nilai default resmi sebelum membandingkan kecocokan argumen. Menganggap argumen opsional sebagai string kosong adalah sumber false rejection tertinggi pada tugas tool-call.
- Terapkan Protokol Anti-Confirmatory Self-Testing: Dalam loop sintesis kode verifier, sistem orchestrator tidak boleh mengizinkan agen menyerahkan verifier jika agen hanya menguji satu varian solusi yang ditulisnya sendiri. Harness wajib menyediakan minimal 3 varian solusi berbeda dari seed yang beragam sebelum verifikator dinyatakan layak pakai (deployable).
Referensi & Sumber Terverifikasi
- [1]VerifierBench: Benchmarking the Generation of Executable Verifiers for LLM Agents(arXiv:2610.28679v1 [cs.SE / cs.AI] — Jianing Yin, Ziyi Chen, Hao Wang, Yiyou Sun, Zijian Jin, Dawn Song, Daoan Zhang (UC Berkeley, UPenn, UIUC, NYU, Univ. of Rochester))
- [2]SWE-bench: Can Language Models Resolve Real-World GitHub Issues?(ICLR 2024 / Princeton NLP — Carlos E. Jimenez, John Yang, Alexander Wettig, Shunyu Yao et al.)
- [3]tau-bench: A Benchmark for Tool-Agent-User Interaction in Realistic Environments(Sierra AI & Stanford University — Shunyu Yao, Noah Shinn, Karthik Narasimhan et al.)
- [4]Berkeley Function-Calling Leaderboard (BFCL v3): Comprehensive Tool Evaluation(Gorilla LLM / UC Berkeley — Fanjia Yan, Huanzhi Mao, Charlie Cheng-Jie Ji et al.)
- [5]InterCode: Standardizing and Benchmarking Interactive Coding with Execution Feedback(NeurIPS 2023 — John Yang, Akshat Shrivastava, Shunyu Yao et al. (Princeton & Meta AI))
Butuh Arsitektur Web & AI Berkualitas Tinggi?
Tim engineering NEWSAINT siap membantu merancang website berkecepatan tinggi, sistem AI autonomous, dan solusi SaaS terukur untuk bisnis Anda.
Artikel Terkait Lainnya

DecisionRAG (arXiv:2610.35868): Retriever-Free Retrieval via Decision Models — Eliminasi Capability Asymmetry, Hierarchical Tree Navigation, dan Rekor +17.4% Hit@1 Tanpa Indeks Vektor
Analisis arsitektur DecisionRAG (arXiv:2610.35868, Chao Wan, Paul Jünger, Beixi Du, Bodong Liu, Navaneetha Krishnan, Kilian Q. Weinberger — Cornell University & ASAPP): Mengapa retrieval konvensional (BM25, dense embeddings) menciptakan capability asymmetry terhadap LLM generator modern, dan bagaimana DecisionRAG menavigasi struktur korpus bertingkat menggunakan model keputusan (decision models) dalam konteks bersama (shared context) tanpa token generasi, menghasilkan lompatan +13.8 R@1 di MultiDoc2Dial, +17.4 Hit@1 di Natural Questions, dan latensi secepat 0.68 detik.

DynaFlow (arXiv:2610.34467): Free-Form Multi-Agent Orchestration — Sintesis Alur Kerja Eksekutabel, Eliminasi Defek Aliran Informasi, dan Lonjakan Akurasi 88.08% Tanpa Mengubah Bobot Sub-Agent
Analisis arsitektur DynaFlow (arXiv:2610.34467, Ruhao Liu et al., NUS): Mengapa topologi multi-agent statis memicu overhead komunikasi berlebihan, dan bagaimana integrasi sintesis alur kerja bebas ke dalam ruang aksi Main Agent — dikombinasikan dengan Two-Stage SFT dan kurasi 3 defek orkestrasi — menghasilkan akurasi 88.08% serta memecahkan 100% soal AIME dengan sub-agent berbobot beku.

Code Graphs & Embeddings pada Small Coding Agents (arXiv:2610.33958): Eksperimen 79k Episode SWE-bench, Gradien Hop Depth, dan Batasan Representasi Leksikal Satu-Langkah
Analisis empiris 79k episode SWE-bench Verified (arXiv:2610.33958, Saurav Bellam): Apakah tool knowledge graph dan embedding search benar-benar melengkapi pemahaman struktural coding agent kecil? Menyingkap degradasi hop gradient (odds ratio 0.50–0.67 per hop), anomali tool uptake pada model 32B, dan bukti linear probing bahwa representasi kode internal agen open-weight masih dominan bersifat leksikal satu-langkah.