Transformers Stop Thinking Too Early 2026: Arsitektur Tiny Rank-8 LoRA pada Single Layer, Relay Mechanism di Lapisan Tengah, dan Penskalaan Rantai Penalaran hingga 160 Baris
Analisis arsitektur sistemik riset frontier deep learning (arXiv:2609.36585, Zehao Jin, Ruixuan Deng, Junran Wang): Mengapa 13 model dasar pretrained (Qwen3, Llama, OLMo, Gemma, hingga DeepSeek-V4-Flash) secara default berhenti melakukan penelusuran referensi kontekstual setelah hanya 1.4–3.6 baris. Menghadirkan terobosan Tiny LoRA, di mana rank-8 LoRA (hanya 65.537 parameter, <0.01% bobot) yang diinjeksi pada SATU lapisan awal dengan seluruh bobot model dibekukan (100% frozen) mampu melipatgandakan akurasi Qwen3-8B pada 24-line assignment chains dari 15.5% menjadi 99.0%, serta memperpanjang jangkauan hingga 160 baris pada model looped Ouro-1.4B. Mengungkap mekanisme estafet (relay) laten di lapisan tengah dan formula prediktif cutoff layer untuk menentukan posisi intervensi optimal.
Transformers Stop Thinking Too Early: Penemuan Batas Dangkal Komputasi Kontekstual dan Solusi Tiny Rank-8 LoRA yang Mengaktifkan Estafet Representasi Laten
Jika sebuah model bahasa diberikan penugasan variabel sederhana seperti K = apple, B = K, D = B, dan ditanya print(D), model dapat menjawab dengan benar tanpa bantuan pengetahuan eksternal. Namun, begitu rantai referensi diperpanjang menjadi beberapa penugasan lebih banyak, kemampuan ini seketika runtuh.
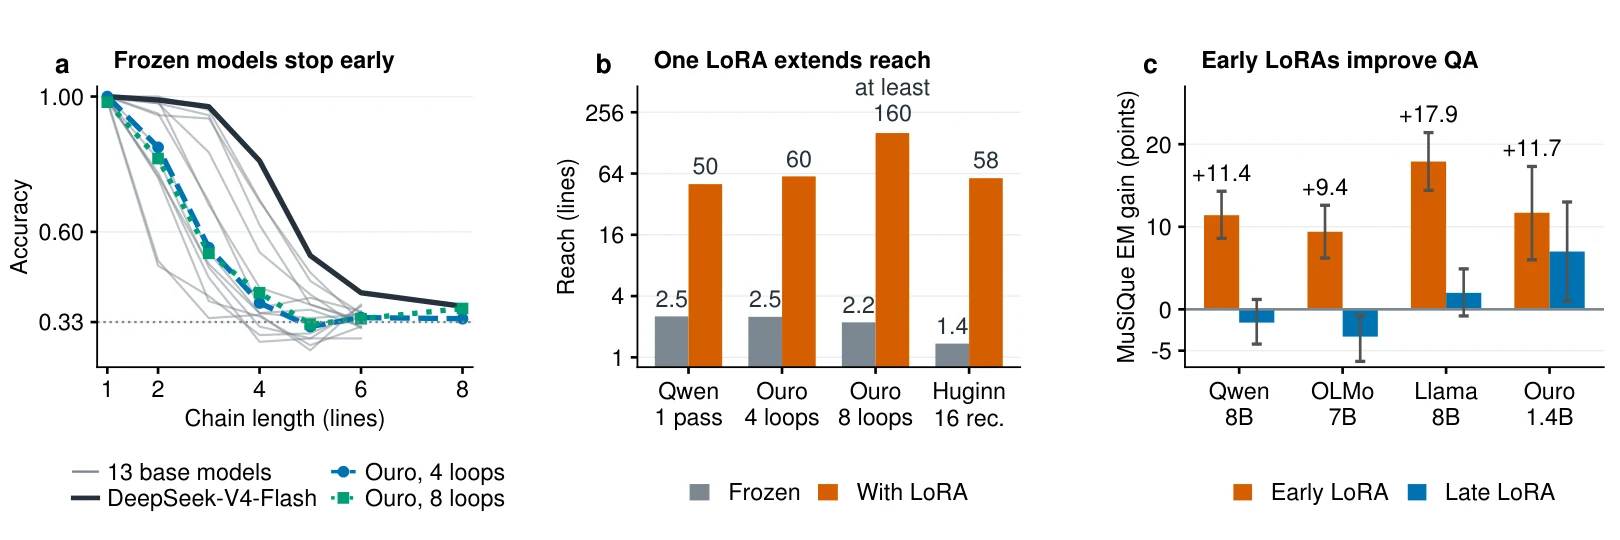
Sebuah studi empiris dan mekanistik mendalam dari Zehao Jin, Ruixuan Deng, dan Junran Wang (arXiv:2609.36585) membuktikan bahwa 13 model dasar pretrained standar (termasuk keluarga Qwen3, Llama-3, OLMo-3, Gemma-3, hingga arsitektur MoE masif DeepSeek-V4-Flash) secara default hanya mampu menelusuri 1.4 hingga 3.6 baris rantai referensi (median 2.2 baris) sebelum komputasi internalnya berhenti.
Yang mengejutkan, kegagalan ini bukan akibat keterbatasan kapasitas arsitektur transformer, melainkan karena model "berhenti berpikir terlalu dini". Dengan melatih tiny rank-8 LoRA hanya pada SATU lapisan awal (hanya 65.537 parameter atau di bawah 0.01% dari bobot total) dengan seluruh bobot dasar 100% dibekukan (frozen), akurasi Qwen3-8B pada 24-line chain melonjak drastis dari 15.5% menjadi 99.0%! Pada arsitektur berulang Ouro-1.4B, intervensi ini membuka kemampuan eksekusi hingga 160 baris penugasan.
1. Mengapa Model Bahasa Modern Berhenti Berpikir Terlalu Dini?
Secara teoretis, arsitektur self-attention pada Transformer memiliki kapasitas komputasi untuk mensimulasikan sirkuit pengikatan variabel (variable binding) dan pelacakan pointer dalam kedalaman tak terbatas (Sanford et al., 2024; Saunshi et al., 2025). Secara praktis, para praktisi berasumsi bahwa model dengan parameter miliaran (7B, 14B, 32B, bahkan 292B MoE) secara otomatis memanfaatkan kedalaman layernya untuk memproses referensi kontekstual yang rumit.
Namun, temuan eksperimental Jin et al. membantah asumsi tersebut. Melalui pengujian ketat pada benchmark rantai referensi (reference chains), para peneliti menemukan fakta mengejutkan di seluruh model dasar terpopuler:
| Arsitektur & Model Dasar | Jumlah Lapisan | Median Jangkauan (Lines) | Akurasi 24-Line (Frozen) | Akurasi 24-Line (+Tiny LoRA) |
|---|---|---|---|---|
| Llama-3.2-1B | 16 | 1.4 | ~0.0% | 6.0 lines unlocked |
| Qwen3-0.6B | 28 | 1.4 | ~0.0% | 9.0 lines unlocked |
| OLMo-3-7B | 32 | 2.1 | 4.5% | 97.0% |
| Llama-3.1-8B | 32 | 2.3 | 5.0% | 96.5% |
| Qwen3-8B | 36 | 2.3 | 15.5% | 99.0% |
| Gemma-3-12B | 40 | 3.6 | 12.0% | 98.5% |
| DeepSeek-V4-Flash (292B MoE) | 60+ | 3.1 | Near-chance | Bottleneck Serupa |
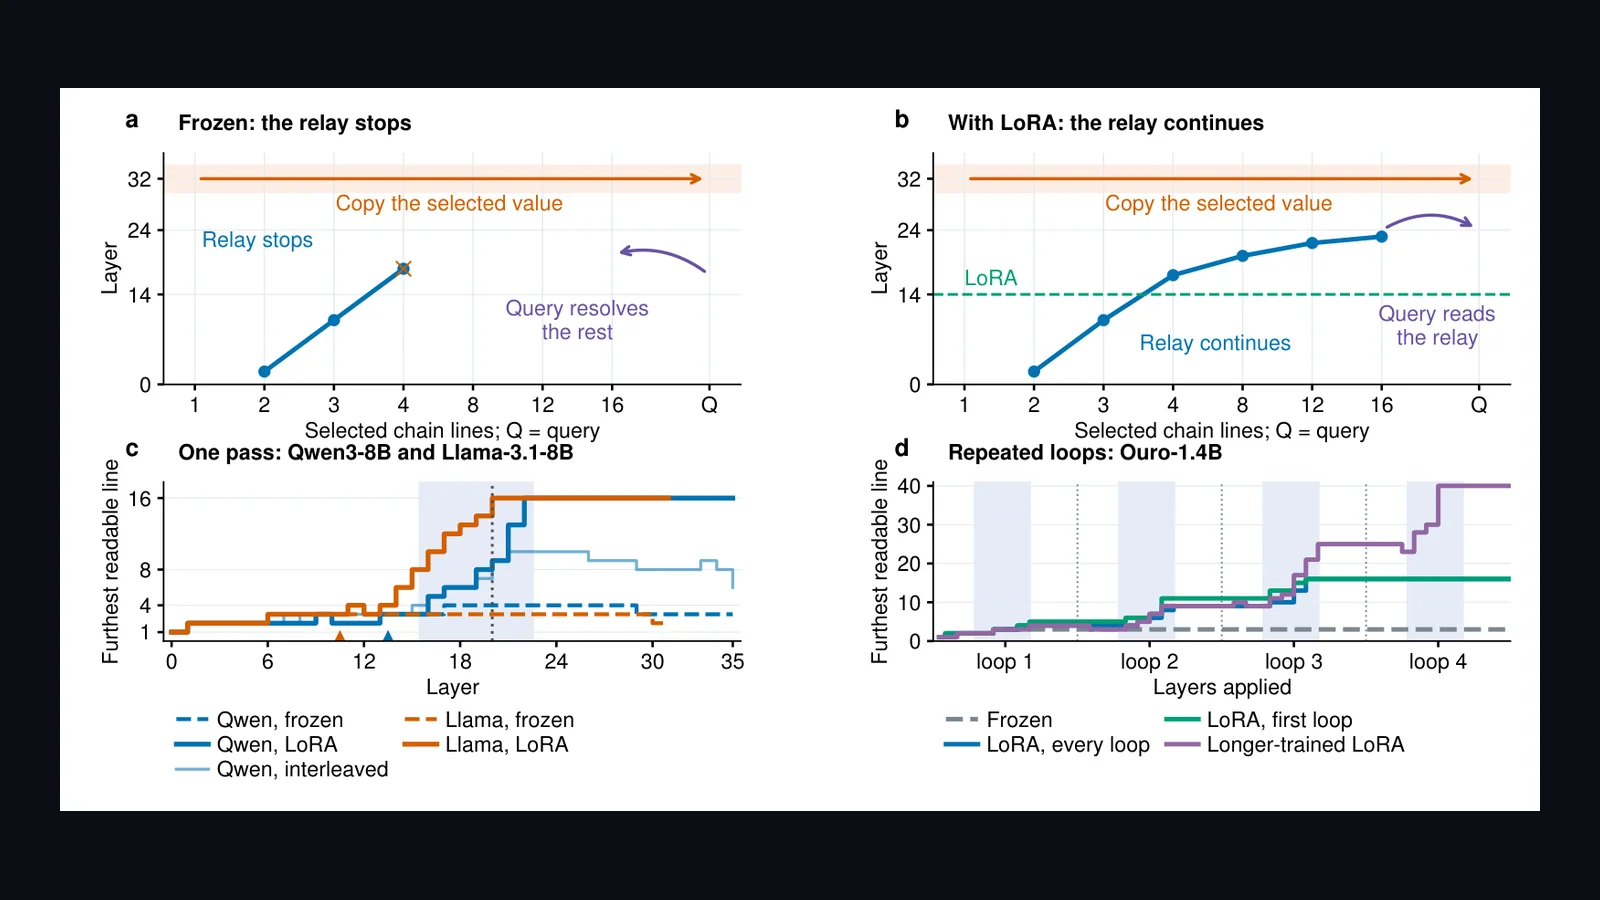
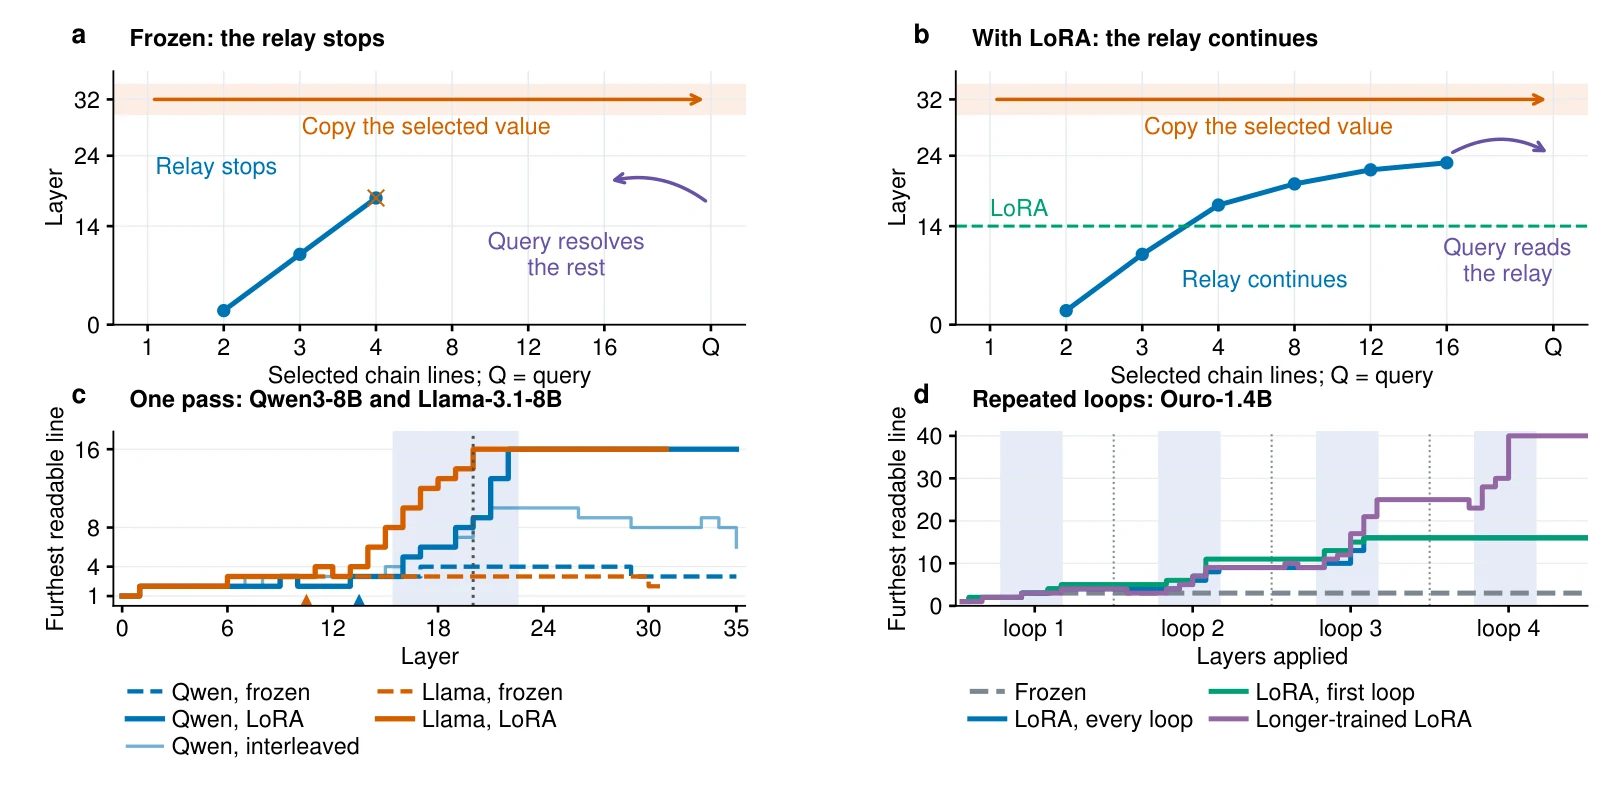
Bahkan pada model dengan puluhan lapis (32 hingga 40 layer), komputasi penyelesaian rantai hanya aktif pada beberapa lapis pertama. Lapisan-lapisan sisanya tidak melanjutkan proses resolusi pointer, melainkan hanya menyalin (copy) representasi statis yang sudah terhenti.
2. Arsitektur Intervensi: Tiny Rank-8 LoRA pada Lapisan Tunggal
Alih-alih melakukan full fine-tuning yang merusak distribusi representasi dasar atau menghabiskan biaya komputasi besar, riset ini merumuskan intervensi minimalis:
- Rank-8 Low-Rank Adaptation (LoRA): Hanya menambahkan matriks adaptasi
A ∈ ℝ^{r × d}danB ∈ ℝ^{d × r}denganr = 8. - Injeksi pada Satu Lapisan Awal (Single Layer): Sebagai contoh, pada Qwen3-8B (36 lapisan), LoRA disematkan secara spesifik di Layer 14.
- 100% Frozen Backbone: Seluruh bobot asli model dibekukan sepenuhnya. Hanya 65.537 parameter yang dilatih (kurang dari 0.0008% dari total 8 miliar parameter model).
- Learned Rescaling Scalar: Transformasi hidden state diformulasikan sebagai:
h ← M(h) = s · h + B · A · hdi mana
sadalah skalar terpelajari yang diinisialisasi mendekati 1.0 (nilai konvergensi pada Qwen3-8B:s = 1.0006).
3. Analisis Mekanistik: Bagaimana LoRA Memulai Efek Estafet (Relay) pada Lapisan Beku
Pertanyaan fundamental dalam sains mekanistik AI: Bagaimana mungkin penambahan 65 ribu parameter di satu layer dapat membuat miliaran bobot beku di atasnya melakukan komputasi penelusuran yang sebelumnya tidak pernah mereka lakukan?
Dengan melakukan pelacakan representasi laten (activation patching dan attention probing), Jin et al. mengungkap fenomena Relay Mechanism:
1. Encoding Identitas Rantai (Chain Identity)
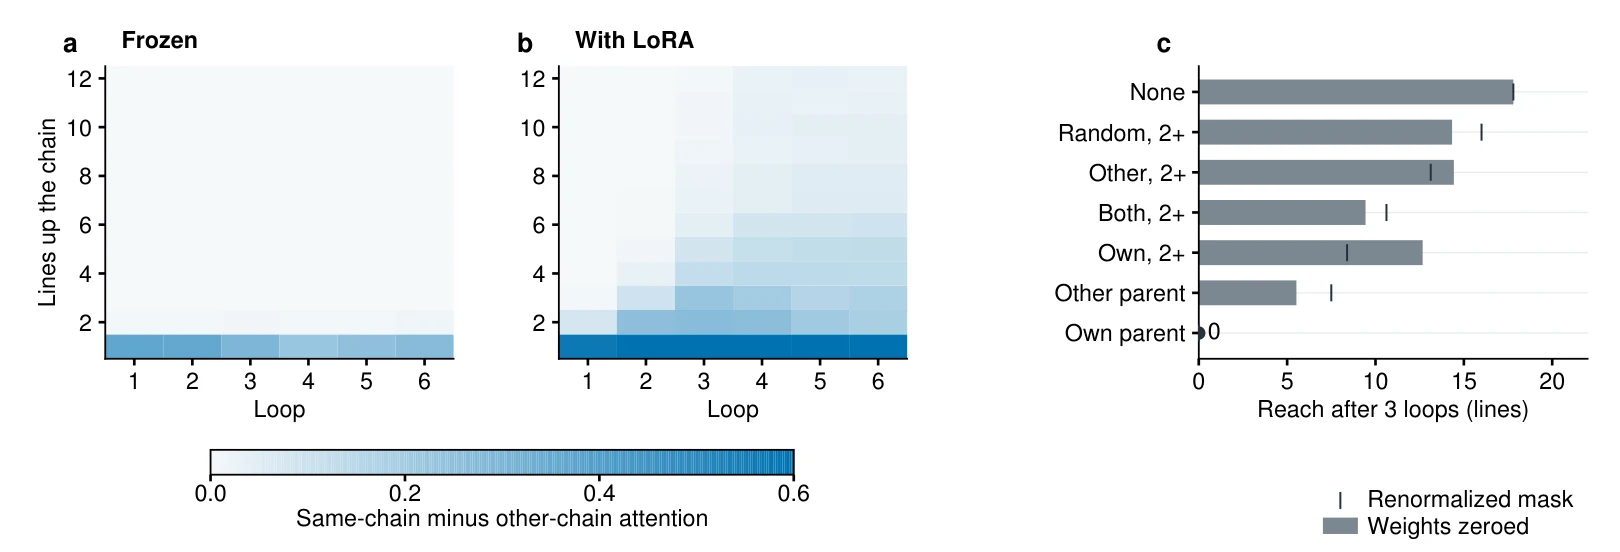
Tanpa LoRA, model gagal mempertahankan identitas rantai penugasan (variabel mana yang berpasangan dengan variabel mana dalam rantai acak). LoRA menyuntikkan koordinat penanda rantai ke dalam representasi laten, memungkinkan layer-layer berikutnya membedakan rantai tanpa tercampur.
2. Pembacaan Pointer Progresif oleh Frozen Heads
Attention heads bawaan yang dibekukan sebenarnya sudah memiliki sirkuit pembacaan referensi, namun sirkuit tersebut tidak aktif jika token tidak memiliki sinyal pemicu. Dengan adanya LoRA di layer 14, attention heads pada layer 16–22 secara progresif membaca 2, 3, 4, 6, hingga 7 baris ke atas pada rantai yang sama.
4. Batas Penempatan Kritis (Sharp Placement Limit) & Rumus Prediksi Cutoff Layer
Salah satu temuan paling krusial bagi praktisi rekayasa AI adalah sensitivitas ekstrem posisi layer. Efek LoRA ini tidak bisa diletakkan di sembarang lapisan:
- Pada Qwen3-8B: Memindahkan LoRA dari Layer 20 ke Layer 21 menjatuhkan jangkauan komputasi secara instan dari 20.5 baris menjadi hanya 5.2 baris!
- Pada OLMo-3-7B: Batas transisi tajam terjadi di antara Layer 12 dan 15.
- Pada Llama-3.1-8B: Batas transisi tajam berada di Layer 13 hingga 15.
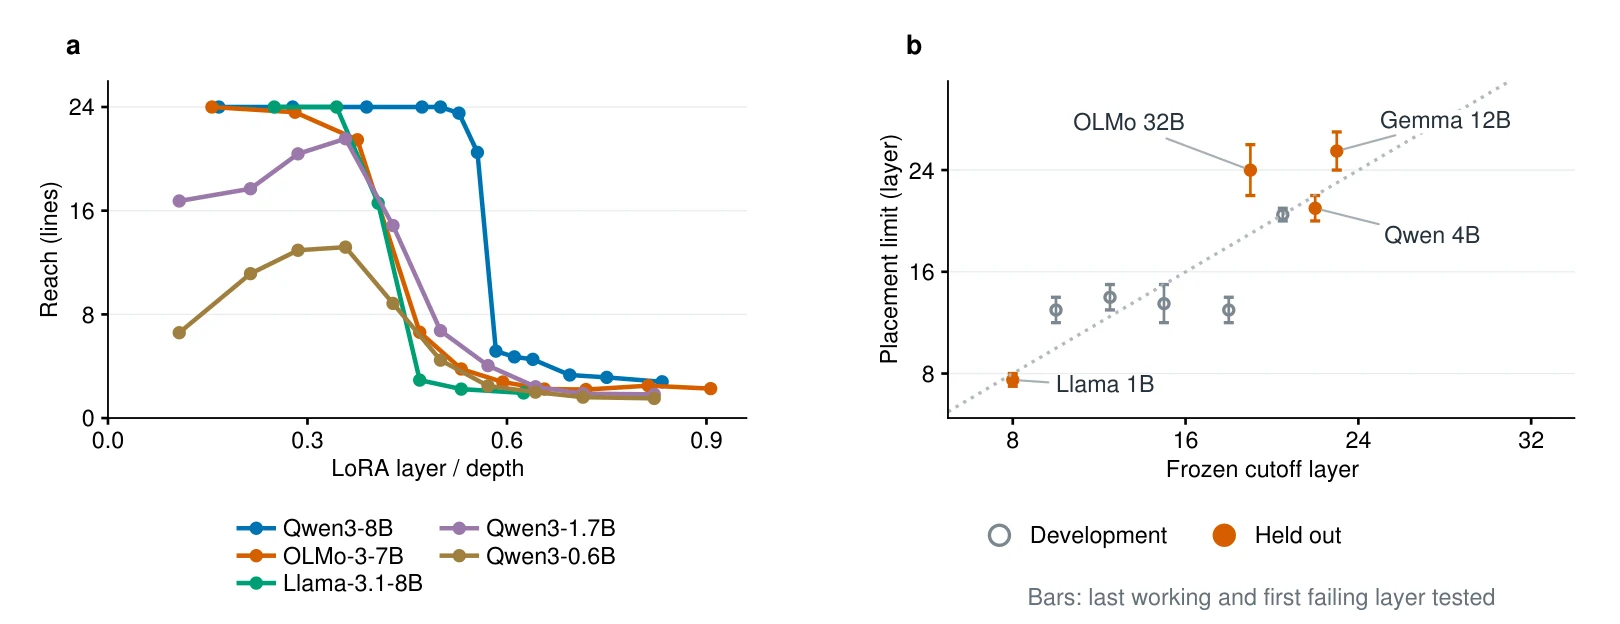
Para peneliti merumuskan metrik Frozen-Model Cutoff Layer untuk memprediksi batas ini secara apriori tanpa perlu melatih LoRA pada setiap layer:
Cutoff layer didefinisikan sebagai lapisan pertama di mana pemulihan token pointer mengembalikan kurang dari setengah efek aslinya (S(p, ℓ) < 0.5). Metrik ini terbukti berhasil memprediksi bracket penempatan layer pada model-model held-out seperti Llama-3.2-1B (bracket 7–8, prediksi 8.0), Qwen3-4B (bracket 20–22, prediksi 22.0), dan Gemma-3-12B (bracket 24–27, prediksi 23.0) dengan akurasi tinggi.
5. Pembuktian Empiris: Generalisasi ke Multi-Hop Reasoning & Benchmark MuSiQue
Apakah fenomena ini hanya terjadi pada kode sintetis variabel penugasan? Untuk membuktikannya, para peneliti menguji dua domain generalisasi:
Penalaran Relasional Faktual (Typed Facts)
Mengganti penugasan variabel dengan fakta bertipe tentang entitas fiktif (misal hubungan keluarga, afiliasi organisasi, lokasi geografis) yang membentuk graf relasi multi-hop.
Benchmark Riil Dunia Nyata: MuSiQue
Evaluasi pada 900 pertanyaan benchmark MuSiQue dengan paragraf-paragraf pendukung yang diacak urutannya untuk menguji penalaran multi-hop tanpa prompt transfer.
6. Implementasi Arsitektur: RelayLoRAModule & Placement Gate
Di bawah ini adalah implementasi sistem modular TypeScript untuk runtime inferensi agen otonom dan serving model yang mengintegrasikan rank-8 LoRA pada lapisan terpilih dengan mekanisme verifikasi cutoff gate:
// Production Implementation: Single-Layer Early Relay LoRA Injector
// Berdasarkan Arsitektur arXiv:2609.36585 (Zehao Jin, Ruixuan Deng, Junran Wang)
//
// Karakteristik Inti:
// 1. Single-Layer Intervention: rank-8 LoRA diinjeksikan HANYA pada satu lapisan awal terpilih
// 2. 100% Frozen Backbone: Seluruh bobot transformer W_base dibekukan sepenuhnya
// 3. Learned Scalar Scaling: h <- s * h + B * A * h dengan s diinisialisasi mendekati 1.0
// 4. Cutoff Layer Placement Gate: Menghitung S(p, l) untuk memverifikasi lapisan sebelum threshold limit

export interface LoRALayerConfig {
  layerIndex: number;
  hiddenDim: number;
  rank: number; // default r = 8
  alpha: number; // default alpha = 16
  initScale?: number; // learned scalar s, default ~1.0006
}

export interface RelayInterventionGate {
  modelName: string;
  totalLayers: number;
  predictedCutoffLayer: number;
  recommendedLoRALayer: number;
}

export class RelayLoRAModule {
  public readonly layerIndex: number;
  public readonly hiddenDim: number;
  public readonly rank: number;
  private scale: number;
  private matrixA: Float32Array; // [rank, hiddenDim]
  private matrixB: Float32Array; // [hiddenDim, rank]

  constructor(config: LoRALayerConfig) {
    this.layerIndex = config.layerIndex;
    this.hiddenDim = config.hiddenDim;
    this.rank = config.rank || 8;
    this.scale = config.initScale ?? 1.0006;

    // Inisialisasi Kaiming-uniform untuk A, dan zero initialization untuk B (standar LoRA)
    this.matrixA = new Float32Array(this.rank * this.hiddenDim);
    this.matrixB = new Float32Array(this.hiddenDim * this.rank);
    this.initMatrices();
  }

  private initMatrices(): void {
    const stdDev = 1.0 / Math.sqrt(this.hiddenDim);
    for (let i = 0; i < this.matrixA.length; i++) {
      this.matrixA[i] = (Math.random() * 2 - 1) * stdDev;
    }
    // Matrix B diinisialisasi dengan 0 agar saat inisialisasi awal Delta-W = 0
    this.matrixB.fill(0);
  }

  /**
   * Forward pass residu: h <- s * h + B * A * h
   * Mengaktivasi relay mechanism tanpa merusak representasi bahasa umum
   */
  public forward(hiddenState: Float32Array): Float32Array {
    const out = new Float32Array(this.hiddenDim);

    // 1. Hitung low-rank bottleneck: z = A * h  [rank]
    const z = new Float32Array(this.rank);
    for (let r = 0; r < this.rank; r++) {
      let sum = 0;
      const offsetA = r * this.hiddenDim;
      for (let d = 0; d < this.hiddenDim; d++) {
        sum += this.matrixA[offsetA + d] * hiddenState[d];
      }
      z[r] = sum;
    }

    // 2. Proyeksikan kembali ke dimensi tersembunyi: delta = B * z [hiddenDim]
    // dan tambahkan ke representasi terskala s * h
    for (let d = 0; d < this.hiddenDim; d++) {
      let delta = 0;
      const offsetB = d * this.rank;
      for (let r = 0; r < this.rank; r++) {
        delta += this.matrixB[offsetB + r] * z[r];
      }
      out[d] = this.scale * hiddenState[d] + delta;
    }

    return out;
  }
}

/**
 * Gate evaluator untuk memverifikasi apakah layer yang dipilih memenuhi cutoff threshold
 */
export function evaluateLayerPlacement(
  model: string,
  targetLayer: number,
  cutoffTable: Record
): { isValid: boolean; message: string } {
  const meta = cutoffTable[model];
  if (!meta) {
    return { isValid: true, message: `Model ${model} tidak memiliki profil cutoff terdaftar. Melanjutkan dengan observasi default.` };
  }

  if (targetLayer >= meta.predictedCutoffLayer) {
    return {
      isValid: false,
      message: `[WARNING] Penempatan layer ${targetLayer} melebihi cutoff (${meta.predictedCutoffLayer}) untuk ${model}. Relay tidak akan teraktivasi (drop reach drastis)!`,
    };
  }

  return {
    isValid: true,
    message: `[OPTIMAL] Layer ${targetLayer} berada di zona aman sebelum cutoff ${meta.predictedCutoffLayer}. Relay diperkirakan aktif sempurna.`,
  };
}
7. Implikasi Arsitektural untuk Komputasi AI Generasi Mendatang
Hasil penelitian dari arXiv:2609.36585 membawa implikasi besar bagi perancangan model masa depan, arsitektur agen otonom, dan optimalisasi inferensi:
- Kapasitas Komputasi yang "Tertidur": Model transformer pretrained default selama ini secara masif under-utilized. Model memiliki bobot dan sirkuit atensi yang mampu melakukan reasoning sangat dalam, namun gagal memicu relay tersebut tanpa sedikit dorongan koordinat representasi di lapisan awal.
- Alternatif Hemat Biaya untuk Looped Transformers: Model berulang (looped architectures seperti Ouro dan Huginn) yang dirancang untuk menghemat memori GPU sering kali dikritik karena penambahan loop tidak meningkatkan akurasi secara linier. Dengan adanya Tiny LoRA, model 1.4B mampu mengeksekusi hingga 160 baris penalaran (setara komputasi model ratusan lapis).
- Surgical Adaptation Tanpa Bencana Lupa (Catastrophic Forgetting): Karena hanya satu layer awal yang dimodifikasi dengan matriks rank-8 (66K parameter), nilai Text KL-divergence tetap mendekati nol (
KL = 0.005), menjaga 100% kelancaran sintaksis dan pengetahuan umum model.
Kesimpulan Redaksional NEWSAINT
Keterbatasan model bahasa dalam memproses konteks panjang dan penalaran berantai sering kali disalahartikan sebagai kekurangan jumlah parameter. Riset ini membuktikan secara definitif: model tidak kekurangan kapasitas—model hanya berhenti berpikir terlalu dini. Injeksi rank-8 LoRA yang terukur secara bedah membuka potensi terpendam miliaran parameter beku, menetapkan paradigma baru bagi efisiensi inferensi, interpretasi mekanistik, dan arsitektur model frontier masa depan.
Referensi & Sumber Terverifikasi
- [1]Transformers Stop Thinking Too Early, and a Tiny LoRA Fixes It(arXiv:2609.36585v1 [cs.CL, cs.AI, cs.LG] — Zehao Jin, Ruixuan Deng, Junran Wang)
- [2]Interactive Project Demo & Open Source Visualizations: Stop Thinking Too Early(LunaMos Open Research Laboratory (lunamos.github.io/stop-thinking-too-early))
- [3]Transformers, Circuits, and the Mechanics of Pointer-Following & In-Context Reasoning(Journal of Machine Learning Research (JMLR) / Stanford AI Lab — Sanford et al.)
- [4]MuSiQue: Multihop Questions via Single-hop Question Composition(Transactions of the Association for Computational Linguistics (TACL) — Trivedi et al.)
- [5]LoRA: Low-Rank Adaptation of Large Language Models(International Conference on Learning Representations (ICLR) — Edward J. Hu et al.)
- [6]Transformers Stop Thinking Too Early, and a Tiny LoRA Fixes It(arXiv:2609.36585v1 [cs.CL, cs.AI, cs.LG] — Zehao Jin, Ruixuan Deng, Junran Wang)
- [7]Interactive Project Demo & Open Source Visualizations: Stop Thinking Too Early(LunaMos Open Research Laboratory (lunamos.github.io/stop-thinking-too-early))
- [8]Transformers, Circuits, and the Mechanics of Pointer-Following & In-Context Reasoning(Journal of Machine Learning Research (JMLR) / Stanford AI Lab — Sanford et al.)
- [9]MuSiQue: Multihop Questions via Single-hop Question Composition(Transactions of the Association for Computational Linguistics (TACL) — Trivedi et al.)
- [10]LoRA: Low-Rank Adaptation of Large Language Models(International Conference on Learning Representations (ICLR) — Edward J. Hu et al.)
Butuh Arsitektur Web & AI Berkualitas Tinggi?
Tim engineering NEWSAINT siap membantu merancang website berkecepatan tinggi, sistem AI autonomous, dan solusi SaaS terukur untuk bisnis Anda.
Artikel Terkait Lainnya

DecisionRAG (arXiv:2610.35868): Retriever-Free Retrieval via Decision Models — Eliminasi Capability Asymmetry, Hierarchical Tree Navigation, dan Rekor +17.4% Hit@1 Tanpa Indeks Vektor
Analisis arsitektur DecisionRAG (arXiv:2610.35868, Chao Wan, Paul Jünger, Beixi Du, Bodong Liu, Navaneetha Krishnan, Kilian Q. Weinberger — Cornell University & ASAPP): Mengapa retrieval konvensional (BM25, dense embeddings) menciptakan capability asymmetry terhadap LLM generator modern, dan bagaimana DecisionRAG menavigasi struktur korpus bertingkat menggunakan model keputusan (decision models) dalam konteks bersama (shared context) tanpa token generasi, menghasilkan lompatan +13.8 R@1 di MultiDoc2Dial, +17.4 Hit@1 di Natural Questions, dan latensi secepat 0.68 detik.

DynaFlow (arXiv:2610.34467): Free-Form Multi-Agent Orchestration — Sintesis Alur Kerja Eksekutabel, Eliminasi Defek Aliran Informasi, dan Lonjakan Akurasi 88.08% Tanpa Mengubah Bobot Sub-Agent
Analisis arsitektur DynaFlow (arXiv:2610.34467, Ruhao Liu et al., NUS): Mengapa topologi multi-agent statis memicu overhead komunikasi berlebihan, dan bagaimana integrasi sintesis alur kerja bebas ke dalam ruang aksi Main Agent — dikombinasikan dengan Two-Stage SFT dan kurasi 3 defek orkestrasi — menghasilkan akurasi 88.08% serta memecahkan 100% soal AIME dengan sub-agent berbobot beku.

Code Graphs & Embeddings pada Small Coding Agents (arXiv:2610.33958): Eksperimen 79k Episode SWE-bench, Gradien Hop Depth, dan Batasan Representasi Leksikal Satu-Langkah
Analisis empiris 79k episode SWE-bench Verified (arXiv:2610.33958, Saurav Bellam): Apakah tool knowledge graph dan embedding search benar-benar melengkapi pemahaman struktural coding agent kecil? Menyingkap degradasi hop gradient (odds ratio 0.50–0.67 per hop), anomali tool uptake pada model 32B, dan bukti linear probing bahwa representasi kode internal agen open-weight masih dominan bersifat leksikal satu-langkah.