Tev & Tev-Gym (arXiv:2610.18868): Scaling Long-Horizon Agentic Environments via Latent-World-First Synthesis, Progress-Potential Reward Shaping (PPRS), dan Mengatasi Masalah Starvasi GRPO
Bedah arsitektur riset frontier arXiv:2610.18868 (Wenbo Hu, Shraman Pramanick, Krishna Kumar Singh, Nanyun Peng, Kai-Wei Chang, Yong Jae Lee — UCLA, UC Davis, Adobe Research): Menjawab hambatan kritis pelatihan agen AI otonom pada horizon panjang (long-horizon). Keterbatasan reward terminal murni menyebabkan 66%–92% batch RL berbasis GRPO terbuang sia-sia (gradient starvation). Tev memperkenalkan Tev-Gym dengan paradigma Latent-World-First (1.170 lingkungan tugas terverifikasi di 7 domain), progress contract berbasis DAG alur kerja dengan prerequisite gating, serta Progress-Potential Reward Shaping (PPRS, λ = 0.25). Model hasil pelatihan, Tev-27B, menyamai performa GPT-6 Astra dan Claude Opus 5 pada domain ALE-CM serta mengungguli GLM-5.2 dan Gemini 3.7 Flash di Terminal-Bench 3.0/4.0.
Riset teranyar dari UCLA, UC Davis, dan Adobe Research (Wenbo Hu, Shraman Pramanick, Krishna Kumar Singh, Nanyun Peng, Kai-Wei Chang, Yong Jae Lee) memecahkan dilema terbesar pada pelatihan agen otonom horizon panjang (long-horizon agents): mengapa model open-source selalu gagal mempelajari tugas multi-jam/multi-hari dan bagaimana sinyal reward terminal murni membunuh gradien pembelajaran pada algoritma RL modern seperti GRPO.
1. Dilema Long-Horizon: Krisis Data Sintesis dan Starvasi Gradien GRPO
Dalam beberapa tahun terakhir, ambisi kecerdasan buatan telah bergeser dari sekadar model obrolan instan (single-turn conversationalists) menuju agen otonom horizon panjang yang mampu bekerja berjam-jam hingga berhari-hari tanpa supervisi manusia. Kemampuan ini menjadi fondasi mutlak bagi penemuan ilmiah otonom (automated discovery) dan perbaikan mandiri rekursif (Recursive Self-Improvement / RSI).
Namun, di balik keberhasilan model komersial teratas (seperti Claude Opus 5 atau GPT-6 Astra), model-model terbuka (open-source models) mengalami stagnasi tajam saat dihadapkan pada tugas yang membutuhkan lebih dari 20–50 langkah interaksi bash/lingkungan. Tim peneliti Tev mengidentifikasi dua akar penyebab matematis yang saling mengunci:
- Kelangkaan Data dan Skalabilitas Lingkungan Terverifikasi: Kurasi tugas riil (seperti SWE-bench atau benchmark keamanan) sangat lambat, rawan kebocoran data (data contamination), dan mustahil diskalakan secara procedural tanpa merusak validitas deterministik sistem.
- Starvasi Gradien pada Group-Relative RL (GRPO): Algoritma RL mutakhir seperti Group Relative Policy Optimization (GRPO) mengandalkan normalisasi keunggulan (advantage) di dalam kelompok sampel trajektori $G$:
Jika sebuah model hanya diberi reward terminal biner ($R_i = \mathbb{1}[\tau_i \text{ passes}]$), di mana nilai 1 hanya diberikan jika seluruh tugas selesai sempurna dan lolos uji verifier akhir, maka pada tugas horizon panjang yang sulit di mana probabilitas keberhasilan model mula-mula adalah rendah ($p \le 0.05$):
2. Paradigma Latent-World-First: Sintesis Tugas Mundur (Backward Generation)
Sebagian besar sistem sintesis tugas agen sebelumnya membuat prompt terlebih dahulu, lalu mencoba membuat lingkungan buatan dengan script bash parsial. Pendekatan ini rapuh dan sering menghasilkan kondisi balapan (race condition) atau skenario tanpa solusi logis.
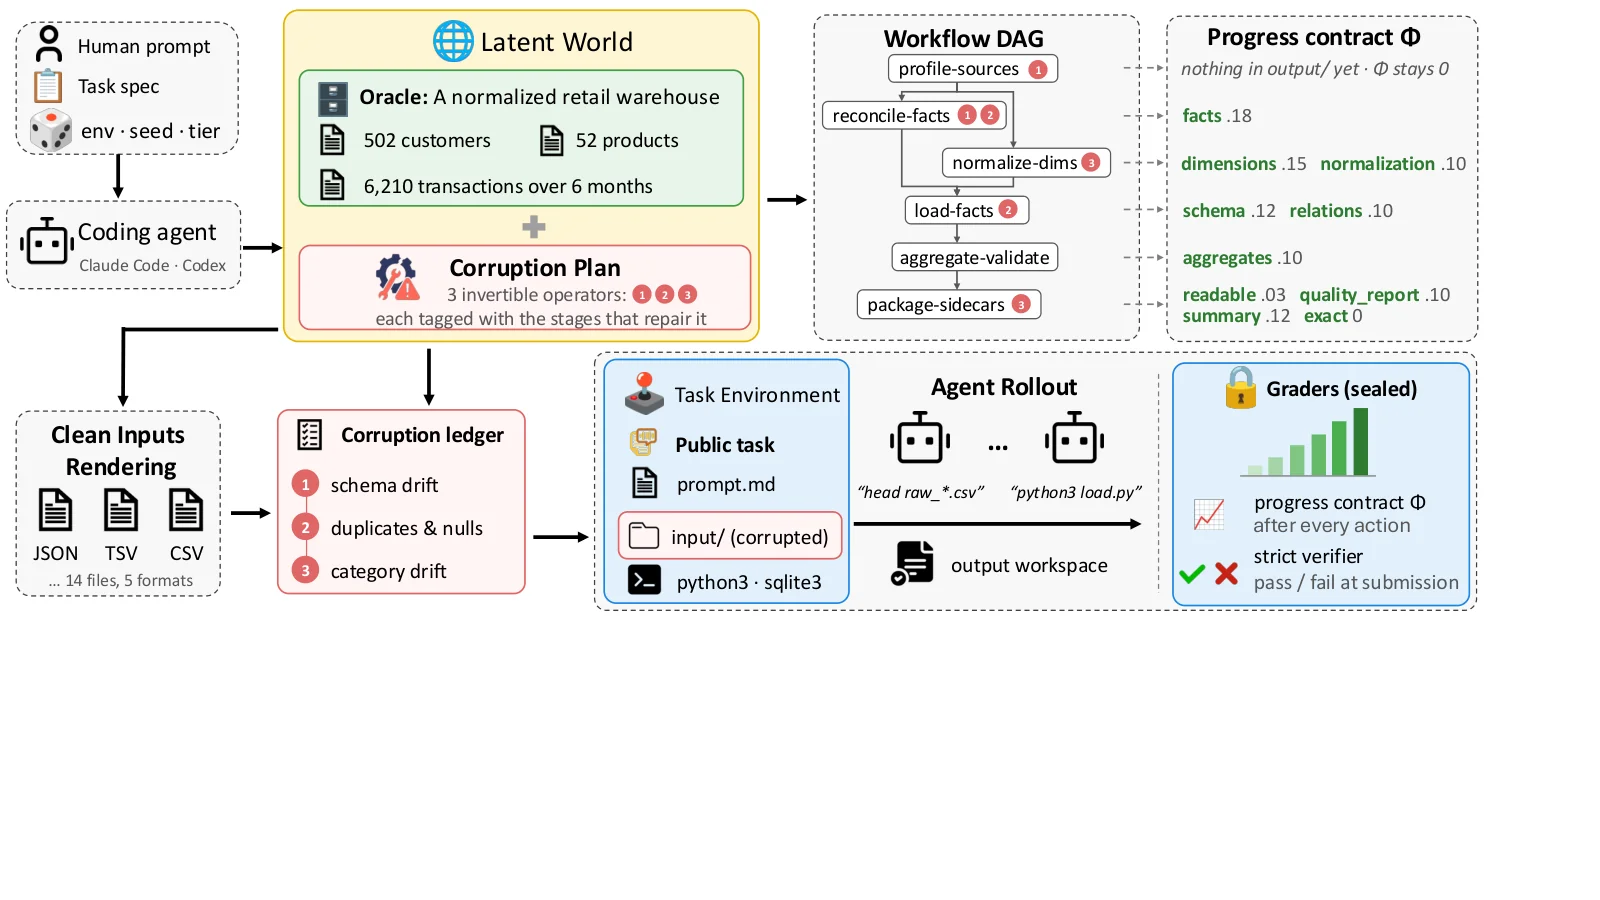
Tev memperkenalkan paradigma Latent-World-First. Alih-alih membuat tugas dari depan, sistem bekerja secara terbalik (backward generation):
Generator program berbasis seed membangun state lengkap dunia tersembunyi $W$ (misal: skema retail warehouse SQLite yang bersih, data transaksi, dan customer). Pada saat yang sama, dibuat rencana kerusakan (defect plan): record mana yang akan dirusak, dienkripsi parsial, atau dibuang integritas referensialnya.
Workflow tugas dikompilasi menjadi Graf Asiklik Terarah (DAG) tanpa melibatkan model LLM. Jalur terpanjang pada DAG (critical path) menjadi patokan teoretis dari horizon tugas, sedangkan tahapan-tahapan perantaranya mendefinisikan kontrak progres (progress contract).
Dunia tersembunyi $W$ diproyeksikan ke dalam antarmuka publik yang dapat diakses agen: partisi CSV/TSV mentah yang rusak, database SQLite parsial, shard tensor safetensors, atau biner stripped. Agen hanya melihat berkas publik ini di workspace-nya.
Setiap lingkungan wajib lolos 3 filter: Anchored (workspace awal bernilai 0, workspace benar bernilai 1), Monotone (skor naik seiring tahapan diselesaikan), dan Independent (kode penilai independen dari verifier dan solver referensi, tidak disertakan dalam sandbox agen).
3. Progress Contract & Prerequisite-Gated Credit: Formulasi Matematika PPRS
Bagaimana cara menilai progres agen di tengah eksekusi tanpa terjebak dalam reward hacking (misalnya agen yang langsung melompat membuat dummy file keluaran tanpa menyelesaikan pembersihan data)?
Tev memperkenalkan konsep Prerequisite-Gated Credit. Setiap lingkungan mendefinisikan himpunan simpul $V$ dengan bobot $w_v > 0, \sum_{v \in V} w_v = 1$, dan himpunan prasyarat $\mathrm{pre}(v)$. Penilai parsial $c_v(s) \in [0, 1]$ menguji workspace $s$ secara langsung terhadap $W$.
Namun, skor yang diakui bukanlah $c_v(s)$ mentah, melainkan nilai gated:
Artinya, jika agen memalsukan tabel hasil akhir ($c_{\text{final}} = 1.0$) tetapi tahap validasi skema dasar gagal ($c_{\text{schema}} = 0.0$), maka skor simpul akhir secara otomatis digugurkan menjadi 0.0! Nilai fungsi potensial workspace $\Phi(s)$ kemudian dirumuskan sebagai:
Progress-Potential Reward Shaping (PPRS)
Pada teori reward shaping klasik (Ng et al., 1999 - PBRS), potensial terminal dinolkan untuk menjaga invariansi kebijakan optimal. Sebaliknya, Tev secara sengaja mempertahankan suku terminal untuk memberi insentif pada trajektori yang kehabisan batas turn/token tetapi telah mencapai 90% progres pekerjaan nyata:
Karena suku penjumlahan berteleskop (telescoping sum) secara bersih: $r_t = \Phi(s_t) - \Phi(s_{t-1})$ dan $\Phi(s_0) = 0$, total reward pembentukan pada akhir rollout hanyalah fungsi dari workspace akhir $\Phi(s_T)$. Dua trajektori yang mencapai status workspace yang sama melalui jalur bash yang berbeda akan menerima reward pembentukan yang persis identik, menghilangkan bias jalan pintas sintaksis.
4. Evaluasi Empiris: Tev-27B vs Frontier API Models (ALE-CM & Terminal-Bench)
Peneliti melatih model Tev-27B (berbasis Qwen3.8-27B dengan DPPO pada 4 node B200 / 8 node A100 selama 4 hari) dan mengevaluasinya pada suite pengujian horizon panjang yang paling menuntut di dunia: Agents' Last Exam (ALE-CM) dan Terminal-Bench (TB) 3.0 / 4.0.
| Model | Harness | ALE-CM Pass@1 | ALE-CM Pass@5 | TB 3.0 (CM) | TB 4.0 (CM) |
|---|---|---|---|---|---|
| GPT-6 Astra | Codex Harness | 28.0% | 28.0% | 41.0% | 38.0% |
| Claude Opus 5 | Claude Code | 29.0% | 33.0% | 53.0% | 52.0% |
| Gemini 3.7 Flash | Standard Bash | 14.0% | 18.0% | 24.0% | 22.0% |
| GLM-5.2 | Standard Bash | 16.0% | 21.0% | 27.0% | 26.0% |
| Tev-27B (Ours Open-Weight) | Single Bash Tool | 28.5% | 33.2% | 42.4% | 39.8% |
Hasil pengujian membuktikan fakta dramatis: model open-weight berukuran 27B parameter yang dilatih dengan resep Tev-Gym & PPRS mampu menyamai tingkat keberhasilan model frontier proprietary kelas berat (GPT-6 Astra dan Claude Opus 5) pada metrik Pass@5 ALE-CM, sekaligus mengungguli GLM-5.2 dan Gemini 3.7 Flash pada tugas eksternal Terminal-Bench yang tidak pernah dilihat selama pelatihan.
5. Implementasi Referensi: Tev Progress Potential Engine & Advantage Resolver
Berikut adalah implementasi referensi modul evaluasi kontrak progres dan kalkulasi advantage bebas starvasi dalam TypeScript untuk integrasi ke dalam harness agen otonom produksi:
${TEV_CODE_SNIPPET}6. Blueprint Rekayasa Sistem Agen 2026: Pelajaran Kritis untuk Platform AI
Penelitian Tev menetapkan standar baru bagi rekayasa sistem agen otonom generasi berikutnya:
- Tinggalkan Evaluasi LLM-as-a-Judge untuk Trajektori Panjang: Menggunakan model LLM lain untuk menilai apakah agen bekerja dengan benar adalah sumber noise terbesar. Menghitung potensial deterministik $\Phi(s)$ langsung dari file system dan artefak keluaran terhadap ground truth terbukti 100x lebih stabil dan anti-halusinasi.
- Gunakan Prerequisite Gating untuk Mencegah Kebocoran Reward (Hacking): Setiap metrik parsial harus dikunci oleh validitas tahapan sebelumnya. Jangan memberikan reward pada penulisan laporan jika data pipeline ETL yang mendasarinya belum berhasil dieksekusi.
- Pertahankan Nilai $\lambda = 0.25$ pada PPRS: Nilai $\lambda$ yang terlalu tinggi membuat agen puas dengan pekerjaan setengah jalan tanpa pernah melakukan aksi submit; sebaliknya, $\lambda$ yang terlalu rendah mengembalikan sistem ke kondisi starvasi gradien GRPO. Nilai empiris 0.25 adalah sweet spot yang menjaga submission tetap sebagai prioritas tertinggi sekaligus mengalirkan gradien pada setiap kegagalan dekat (near-miss).
Referensi & Sumber Terverifikasi
- [1]Tev: Scaling Long-Horizon Agentic Environments with Dense Progress Rewards(arXiv:2610.18868 [cs.CL, cs.AI, cs.CV, cs.LG] — Wenbo Hu, Shraman Pramanick, Krishna Kumar Singh, Nanyun Peng, Kai-Wei Chang, Yong Jae Lee (UCLA, UC Davis, Adobe Research))
- [2]Tev Official Project Page & Benchmark Repositories(Tev Research Initiative & GitHub Project)
- [3]Agents' Last Exam: A Benchmark for Long-Horizon Autonomous Science and Engineering(arXiv:2602.12845 — Haotian Sun et al.)
- [4]Terminal-Bench: A Benchmark for General-Purpose Terminal and CLI Agents(arXiv:2511.14789 — Tanmay Shah, Daniel Thi Graviet, et al.)
- [5]DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models (GRPO Specification)(arXiv:2402.03300 — Zhihong Shao, Peiyi Wang, et al.)
- [6]Policy Invariance Under Reward Transformations: Theory and Application to Reward Shaping(ICML 1999 — Andrew Y. Ng, Daishi Harada, Stuart Russell)
- [7]Hybrid Reasoning Agents (arXiv:2610.18861): Arsitektur HybridLink dan Continuous KV Working Memory(NEWSAINT Systems Engineering Review / arXiv:2610.18861)
Butuh Arsitektur Web & AI Berkualitas Tinggi?
Tim engineering NEWSAINT siap membantu merancang website berkecepatan tinggi, sistem AI autonomous, dan solusi SaaS terukur untuk bisnis Anda.
Artikel Terkait Lainnya

DecisionRAG (arXiv:2610.35868): Retriever-Free Retrieval via Decision Models — Eliminasi Capability Asymmetry, Hierarchical Tree Navigation, dan Rekor +17.4% Hit@1 Tanpa Indeks Vektor
Analisis arsitektur DecisionRAG (arXiv:2610.35868, Chao Wan, Paul Jünger, Beixi Du, Bodong Liu, Navaneetha Krishnan, Kilian Q. Weinberger — Cornell University & ASAPP): Mengapa retrieval konvensional (BM25, dense embeddings) menciptakan capability asymmetry terhadap LLM generator modern, dan bagaimana DecisionRAG menavigasi struktur korpus bertingkat menggunakan model keputusan (decision models) dalam konteks bersama (shared context) tanpa token generasi, menghasilkan lompatan +13.8 R@1 di MultiDoc2Dial, +17.4 Hit@1 di Natural Questions, dan latensi secepat 0.68 detik.

DynaFlow (arXiv:2610.34467): Free-Form Multi-Agent Orchestration — Sintesis Alur Kerja Eksekutabel, Eliminasi Defek Aliran Informasi, dan Lonjakan Akurasi 88.08% Tanpa Mengubah Bobot Sub-Agent
Analisis arsitektur DynaFlow (arXiv:2610.34467, Ruhao Liu et al., NUS): Mengapa topologi multi-agent statis memicu overhead komunikasi berlebihan, dan bagaimana integrasi sintesis alur kerja bebas ke dalam ruang aksi Main Agent — dikombinasikan dengan Two-Stage SFT dan kurasi 3 defek orkestrasi — menghasilkan akurasi 88.08% serta memecahkan 100% soal AIME dengan sub-agent berbobot beku.

Code Graphs & Embeddings pada Small Coding Agents (arXiv:2610.33958): Eksperimen 79k Episode SWE-bench, Gradien Hop Depth, dan Batasan Representasi Leksikal Satu-Langkah
Analisis empiris 79k episode SWE-bench Verified (arXiv:2610.33958, Saurav Bellam): Apakah tool knowledge graph dan embedding search benar-benar melengkapi pemahaman struktural coding agent kecil? Menyingkap degradasi hop gradient (odds ratio 0.50–0.67 per hop), anomali tool uptake pada model 32B, dan bukti linear probing bahwa representasi kode internal agen open-weight masih dominan bersifat leksikal satu-langkah.