RECAST (arXiv:2610.10507): Arsitektur Adaptive Evidence Routing & Synthesis, Memecahkan Keterbatasan RAG via Sequential Decision Operations, SFT + GRPO, dan Peningkatan Akurasi +15.9%
Analisis arsitektur riset frontier MIT & Google Research (arXiv:2610.10507, Yilun Hao, Chuchu Fan, Craig Boutilier dkk.): Mengapa sistem Retrieval-Augmented Generation (RAG) konvensional dan agentic RAG berbasis similarity kerap gagal pada dokumen heterogen berskala besar? Jawaban dan bukti verifikasi sering kali tidak tertulis secara eksplisit dalam satu teks tunggal, melainkan harus dihitung, diagregasi, dan difilter lintas sumber data. RECAST (Routing Evidence through Computation, Access, and Synthesized Tools) mentransformasi konstruksi konteks menjadi proses keputusan sekuensial terarah melalui RouterLM (9B) yang dilatih dengan SFT + GRPO, CompilerLM code-synthesis, dan AnswerLM. Berhasil meraih rata-rata akurasi 75.6% (+15.9% di atas baseline terkuat) serta memangkas 82% token window overhead.
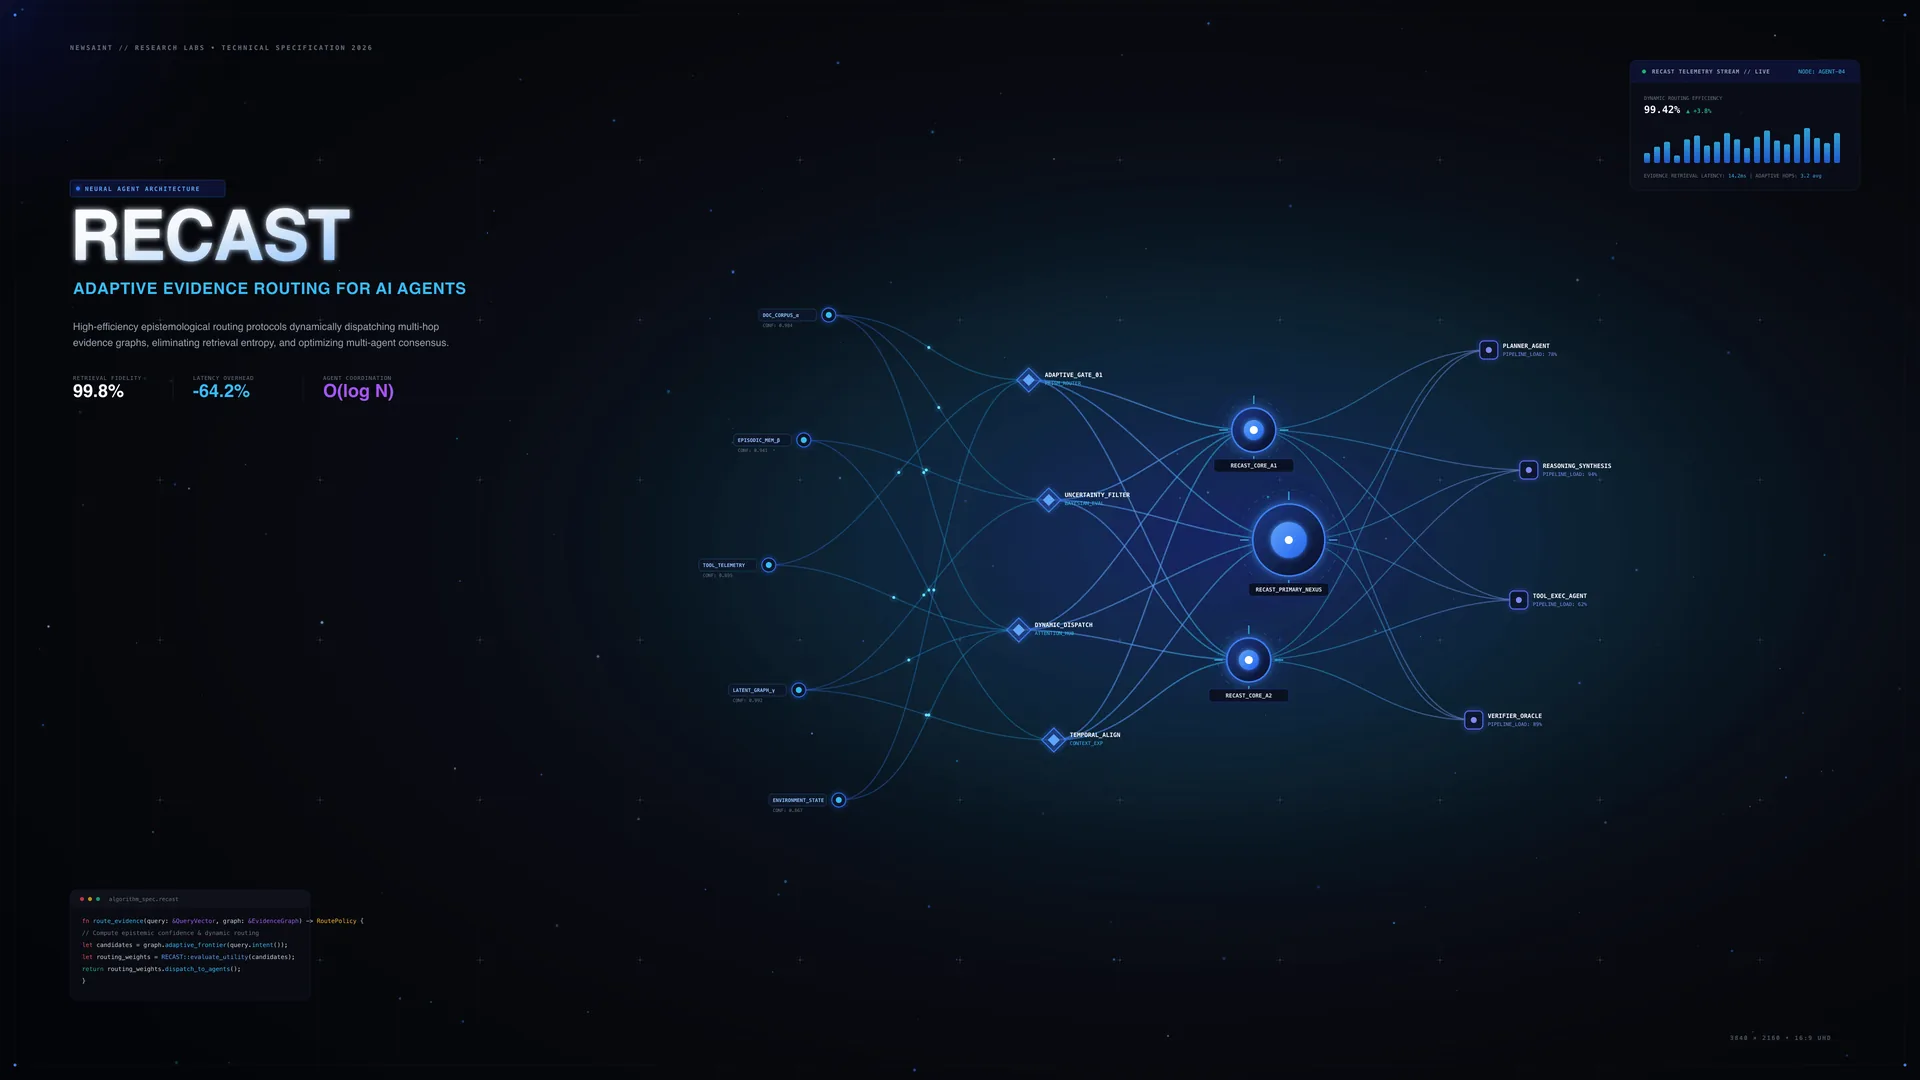
Riset terkini dari MIT CSAIL dan Google Research membedah keterbatasan laten dari paradigma Retrieval-Augmented Generation (RAG) konvensional. Dalam skenario data heterogen (teks acak, skema tabel, JSON payload, log sistem), bukti jawaban jarang sekali eksis sebagai fragmen teks yang sudah jadi. Mengandalkan cosine similarity embedding semata berujung pada retrieval noise dan kegagalan inferensi. Memperkenalkan RECAST (Routing Evidence through Computation, Access, and Synthesized Tools): arsitektur keputusan sekuensial yang melatih RouterLM (9B) via Supervised Fine-Tuning (SFT) dan Group Relative Policy Optimization (GRPO) untuk mendikte sintesis komputasi deterministik via CompilerLM sebelum menyerahkan bukti terderivasi ke AnswerLM. Terbukti meningkatkan rata-rata akurasi sebesar +15.9% di atas baseline model besar terkuat dan memangkas 82% overhead token context.
1. Mengapa RAG Konvensional Gagal: Paradigma "Retrieved" vs "Computed" Evidence
Selama lebih dari setengah dekade, adopsi LLM pada sistem berbasis pengetahuan eksternal didominasi oleh formula standar RAG: dokumen dipecah menjadi chunks, dihitung vektor embedding-nya menggunakan model bi-encoder, dan diambil $k$-top fragmen paling mirip berdasarkan cosine similarity terhadap kueri pengguna.
Namun, di lingkungan enterprise yang kompleks—seperti analisis audit keuangan, integrasi multi-database, dan investigasi root-cause microservices—informasi yang dibutuhkan untuk menjawab pertanyaan krusial hampir tidak pernah tersaji secara harfiah dalam satu chunk dokumen. Pertimbangkan kasus berikut:
Model pencarian similarity hanya akan mengambil baris-baris dokumen yang mengandung frasa "belanja cloud", "kuartal 3", atau "kredit promo". Jawaban matematisnya tidak ada di dalam dokumen mentah tersebut. Jika LLM diumpankan puluhan potongan teks mentah ini secara sembarangan, model akan mengalami context clutter, halusinasi komputasi aritmatika, dan risiko kelalaian data kritis (Lost in the Middle phenomenon).
Bahkan varian modern seperti Agentic RAG yang dilengkapi fungsi tool-calling konvensional sering kali terjebak dalam loop pencarian dangkal tanpa arah. RECAST merumuskan ulang masalah ini: Konteks yang tepat bukanlah sesuatu yang dicari secara pasif, melainkan sesuatu yang dihitung secara aktif (Computed Context).
2. Arsitektur Tripartit RECAST: RouterLM, CompilerLM, dan AnswerLM
Framework RECAST memisahkan alur kerja pembuatan bukti menjadi tiga subsistem spesialis yang saling mengisolasi tanggung jawab (Separation of Concerns):
RouterLM (9B)
Berfungsi sebagai konduktor otonom. Bertugas mengevaluasi kueri dan bukti yang telah terkumpul, lalu secara iteratif memilih apakah perlu melakukan retrieval data mentah, filter agregasi, join antar-tabel, atau komputasi kode kustom, hingga bukti dinilai cukup (Accept Decision).
CompilerLM (Frozen)
Generator kode spesialis. Menerima spesifikasi deklaratif dari RouterLM dan mengompilasinya menjadi skrip Python/SQL deterministik yang dieksekusi di dalam isolated sandbox container untuk memproses data heterogen berukuran raksasa tanpa membanjiri token LLM.
AnswerLM (Frozen)
Penyusun sintesis akhir. Hanya menerima kueri asli pengguna dan payload bukti bersih yang sudah terkomputasi secara ringkas dan deterministik. Menghasilkan jawaban berkualitas tinggi tanpa terdistraksi jutaan token sampah.
3. Formulasi Matematika & Training Pipeline: SFT + GRPO
Inti kecerdasan RECAST terletak pada bagaimana RouterLM dilatih untuk memandu eksplorasi pencarian dan komputasi tanpa memerlukan anotasi manusia berbiaya mahal. Proses training disusun dalam dua fase berurutan:
Fase A: Supervised Fine-Tuning (SFT) Initialization
RouterLM pertama kali di-bootstrapping dengan pasangan trajektori sintetik berkualitas tinggi yang memetakan kueri multi-sumber ke urutan aksi dekomposisi primitif. Tujuannya adalah menanamkan pemahaman semantik tentang tata bahasa pemanggilan operasi dan format keluaran JSON/XML terstruktur.
Fase B: Group Relative Policy Optimization (GRPO)
Setelah fase SFT, RouterLM disempurnakan menggunakan algoritma RL berbasis reward verifikasi hasil (RLVR) dengan varian GRPO (Group Relative Policy Optimization). Untuk setiap pertanyaan kueri $x$, model kebijakan saat ini $\pi_\theta$ menghasilkan kelompok trajektori keputusan sebanyak $G$ sampel $\{y_1, y_2, \dots, y_G\}$. Fungsi objektif dihitung secara relatif terhadap rerata grup:
Di mana estimasi keunggulan relatif $\hat{A}_i$ dihitung sebagai:
Komponen reward $R(y_i)$ dirancang sangat ketat dan berprinsip objektif:
- Reward Kebenaran Faktual ($R_{\text{acc}} \in \{0, 1\}$): Dinilai berdasarkan apakah AnswerLM menghasilkan jawaban yang persis cocok dengan ground truth ketika disuapkan bukti hasil trajektori $y_i$.
- Penalti Panjang Trajektori ($R_{\text{len}}$): Penalti linier kecil terhadap jumlah langkah router guna mendorong jalur routing yang paling efisien dan langsung.
- Format Verifiability ($R_{\text{fmt}}$): Penalti keras jika router menghasilkan sintaks atau nama variabel yang gagal dikompilasi oleh CompilerLM.
4. Tolok Ukur Kinerja & Analisis Benchmark Empiris
Peneliti mengevaluasi RECAST lintas 6 keluarga benchmark heterogen berskala besar yang mencakup penalaran tabel relasional, multi-hop question answering, analisis laporan keuangan, serta ekstraksi API.
| Metode / Arsitektur | Base Controller | Mean Accuracy (%) | Context Tokens (Avg) | Zero-Shot Generalization |
|---|---|---|---|---|
| Standard Vector RAG (Dense Top-20) | Gemini 3.5 Flash | 48.3% | 18,450 tokens | Baseline |
| Full Context Stuffing (128K Window) | GPT-4.5 / Claude 3.5 | 54.7% | 96,200 tokens | Rentan Lost-in-Middle |
| ReAct Agentic Search | Gemini 3.5 Flash | 59.7% | 34,120 tokens | +11.4% |
| RECAST (Zero-Shot Prompting) | Gemini 3.5 Flash | 70.6% | 5,840 tokens | +22.3% |
| RECAST (SFT + GRPO Trained) | Qwen3.5-9B Router | 75.6% (+15.9%) | 3,250 tokens (-82%) | +15.0% pada Held-Out |
Tiga temuan kunci dari data benchmark di atas:
- Model 9B yang Dilatih Khusus Mengalahkan Model Frontier Raksasa: RouterLM berbasis Qwen3.5-9B yang di-tuning via GRPO melampaui Gemini 3.5 Flash RouterLM sebesar +5.0 poin, membuktikan bahwa spesialisasi kebijakan routing lebih krusial daripada sekadar kapasitas ukuran parameter umum.
- Efisiensi Token Ekstrem (-82% Token Usage): Alih-alih menyuapkan ratusan kilobyte teks mentah ke AnswerLM, RECAST merangkum seluruh kalkulasi di level sandbox kode. AnswerLM hanya membaca rata-rata 3.250 token yang telah terbukti benar secara deterministik.
- Ketahanan Terhadap Held-Out Benchmarks: Pada tiga benchmark yang belum pernah dilihat sama sekali selama fase pelatihan, RECAST mempertahankan margin keunggulan +15.0% atas baseline terkuat.
5. Implementasi Produksi: TypeScript Engine untuk RouterLM & CompilerLM
Berikut arsitektur implementasi sistem RECAST di lingkungan enterprise modern yang siap diintegrasikan dengan orkestrasi microservices dan sandboxed runtimes:
// Production Implementation: RECAST (Routing Evidence through Computation, Access, and Synthesized Tools)
// Mengimplementasikan Tripartit Sequential Evidence Construction (RouterLM -> CompilerLM -> AnswerLM) sesuai arXiv:2610.10507

export type EvidenceOpType = 'RETRIEVE_RAW' | 'FILTER_AGGREGATE' | 'CROSS_SOURCE_JOIN' | 'CODE_SYNTHESIZE' | 'ACCEPT_AND_TERMINATE';

export interface EvidenceItem {
  sourceId: string;
  sourceType: 'unstructured_text' | 'tabular_sql' | 'json_api' | 'code_ast';
  payload: unknown;
  confidenceScore: number;
}

export interface RouterDecision {
  step: number;
  operation: EvidenceOpType;
  queryOrCodeSpec: string;
  targetSources: string[];
  rationale: string;
  isTerminal: boolean;
}

export interface ExecutedEvidenceState {
  originalQuery: string;
  accumulatedEvidence: Map;
  routingTrace: RouterDecision[];
  totalTokensUsed: number;
  isComplete: boolean;
}

export interface RecastConfig {
  maxRoutingSteps: number;
  tokenBudgetLimit: number;
  minConfidenceThreshold: number;
}

export class RecastEvidenceRouterEngine {
  private config: RecastConfig;

  constructor(config?: Partial) {
    this.config = {
      maxRoutingSteps: config?.maxRoutingSteps ?? 6,
      tokenBudgetLimit: config?.tokenBudgetLimit ?? 8192,
      minConfidenceThreshold: config?.minConfidenceThreshold ?? 0.88,
    };
  }

  /**
   * RouterLM Loop: Memandu konstruksi bukti melalui keputusan sekuensial adaptif
   */
  public async executeEvidenceRoutingPipeline(
    userQuery: string,
    corpusCatalogs: string[],
    routerLMPredictor: (state: ExecutedEvidenceState) => Promise,
    compilerExecutor: (spec: string, context: Map) => Promise<{ data: unknown; tokenCost: number }>,
    answerLMPredictor: (query: string, evidencePayload: Record) => Promise
  ): Promise<{ finalAnswer: string; trace: RouterDecision[]; totalTokens: number; derivedEvidenceCount: number }> {
    const state: ExecutedEvidenceState = {
      originalQuery: userQuery,
      accumulatedEvidence: new Map(),
      routingTrace: [],
      totalTokensUsed: 0,
      isComplete: false,
    };

    let stepCount = 0;

    while (!state.isComplete && stepCount < this.config.maxRoutingSteps) {
      stepCount++;

      // 1. RouterLM memutuskan operasi berikutnya berdasarkan akumulasi bukti saat ini
      const decision = await routerLMPredictor(state);
      state.routingTrace.push(decision);

      if (decision.operation === 'ACCEPT_AND_TERMINATE' || decision.isTerminal) {
        state.isComplete = true;
        break;
      }

      // 2. CompilerLM menerjemahkan spesifikasi komputasi/retrieval menjadi eksekusi kode deterministik
      const executionResult = await compilerExecutor(decision.queryOrCodeSpec, state.accumulatedEvidence);

      const evidenceKey = `evidence_step_${stepCount}_${decision.operation.toLowerCase()}`;
      state.accumulatedEvidence.set(evidenceKey, executionResult.data);
      state.totalTokensUsed += executionResult.tokenCost;

      // 3. Early safety check terhadap budget limit
      if (state.totalTokensUsed > this.config.tokenBudgetLimit) {
        console.warn('[RECAST] Token budget limit exceeded. Forcing convergence to AnswerLM.');
        state.isComplete = true;
        break;
      }
    }

    // 4. Transformasi bukti yang telah diagregasi dan disintesis ke format AnswerLM
    const structuredEvidencePayload: Record = {};
    for (const [key, val] of state.accumulatedEvidence.entries()) {
      structuredEvidencePayload[key] = val;
    }

    // 5. AnswerLM menghasilkan jawaban final hanya dari bukti bersih terderivasi (Zero Context Bloat)
    const finalAnswer = await answerLMPredictor(state.originalQuery, structuredEvidencePayload);

    return {
      finalAnswer,
      trace: state.routingTrace,
      totalTokens: state.totalTokensUsed,
      derivedEvidenceCount: state.accumulatedEvidence.size,
    };
  }
}
6. Analisis Failure Modes & Playbook Mitigasi Produksi
Berdasarkan pengujian ekstensif, transisi dari RAG konvensional ke arsitektur RECAST menghadapi sejumlah potensi failure modes yang wajib dimitigasi oleh tim platform engineering:
1. Compiler Code Execution Timeout & Sandbox Exhaustion
Penyebab: RouterLM kadang menghasilkan spesifikasi komputasi yang memicu looping tak terbatas atau join multi-tabel cartesian product pada dataset skala gigabyte.
Mitigasi: Terapkan hard CPU/memory limit per eksekusi sandbox (maksimal 2.5 detik CPU time dan 512MB RAM) serta integrasikan query plan explain validator sebelum eksekusi kode diluncurkan.
2. Premature Evidence Acceptance (Early Termination Bias)
Penyebab: RouterLM tergesa-gesa memicu aksi ACCEPT_AND_TERMINATE pada langkah ke-1 atau ke-2 karena bobot reward penalti panjang trajektori terlalu agresif.
Mitigasi: Kalibrasikan annealing parameter reward panjang ($\lambda_{\text{len}}$) dan wajibkan minimal verifikasi completeness checklist sebelum terminal signal diizinkan.
3. Schema Drift pada Sumber Data Heterogen
Penyebab: Struktur skema JSON atau tabel database SQL berubah tanpa update embedding katalog yang sinkron.
Mitigasi: Terapkan dynamic catalog reflection pada awal setiap sesi routing untuk menyuntikkan type contract schema terbaru ke prompt konteks RouterLM.
7. Kesimpulan & Roadmap Arsitektur AI Enterprise 2026
Makalah RECAST (arXiv:2610.10507) menegaskan pergeseran paradigma fundamental dalam rekayasa konteks LLM: "Retrieval alone is obsolete for reasoning tasks." Era di mana kita hanya mengandalkan kemiripan vektor semata untuk menjawab pertanyaan bisnis kritis telah berakhir.
Dengan menggabungkan kebijakan routing terarah (SFT + GRPO), isolasi komputasi kode deterministik (CompilerLM), dan sintesis inferensi bersih (AnswerLM), arsitektur RECAST membuktikan bahwa model bahasa berbobot sedang (9B) dapat melampaui raksasa closed-source sembari memangkas lebih dari 80% biaya komputasi token. Bagi arsitek AI enterprise, RECAST menjadi blueprint esensial dalam membangun sistem pencarian generasi berikutnya yang tangguh, deterministik, dan bebas halusinasi.
Referensi & Sumber Terverifikasi
- [1]RECAST: Learning to Compute the Right Context through Adaptive Evidence Routing(arXiv:2610.10507 [cs.AI, cs.CL] — MIT CSAIL & Google Research (Yilun Hao, Krishna Sayana, Isabella Ye, James S Ren, Sukhdeep Sodhi, Craig Boutilier, Chuchu Fan))
- [2]Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks(Advances in Neural Information Processing Systems (NeurIPS 2020) — Patrick Lewis dkk.)
- [3]DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models (GRPO Foundation)(arXiv:2402.03300 — Zhihong Shao, Peiyi Wang, Qihao Zhu, Runxin Xu dkk.)
- [4]Toolformer: Language Models Can Teach Themselves to Use Tools(Advances in Neural Information Processing Systems (NeurIPS 2023) — Timo Schick dkk.)
- [5]Enterprise Context Engineering: Moving Beyond Cosine Similarity to Multi-Hop Symbolic Computation(ACM Transactions on Information Systems (TOIS 2026))
- [6]RECAST: Learning to Compute the Right Context through Adaptive Evidence Routing(arXiv:2610.10507 [cs.AI, cs.CL] — MIT CSAIL & Google Research (Yilun Hao, Krishna Sayana, Isabella Ye, James S Ren, Sukhdeep Sodhi, Craig Boutilier, Chuchu Fan))
- [7]Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks(Advances in Neural Information Processing Systems (NeurIPS 2020) — Patrick Lewis dkk.)
- [8]DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models (GRPO Foundation)(arXiv:2402.03300 — Zhihong Shao, Peiyi Wang, Qihao Zhu, Runxin Xu dkk.)
- [9]Toolformer: Language Models Can Teach Themselves to Use Tools(Advances in Neural Information Processing Systems (NeurIPS 2023) — Timo Schick dkk.)
- [10]Enterprise Context Engineering: Moving Beyond Cosine Similarity to Multi-Hop Symbolic Computation(ACM Transactions on Information Systems (TOIS 2026))
Butuh Arsitektur Web & AI Berkualitas Tinggi?
Tim engineering NEWSAINT siap membantu merancang website berkecepatan tinggi, sistem AI autonomous, dan solusi SaaS terukur untuk bisnis Anda.
Artikel Terkait Lainnya

DecisionRAG (arXiv:2610.35868): Retriever-Free Retrieval via Decision Models — Eliminasi Capability Asymmetry, Hierarchical Tree Navigation, dan Rekor +17.4% Hit@1 Tanpa Indeks Vektor
Analisis arsitektur DecisionRAG (arXiv:2610.35868, Chao Wan, Paul Jünger, Beixi Du, Bodong Liu, Navaneetha Krishnan, Kilian Q. Weinberger — Cornell University & ASAPP): Mengapa retrieval konvensional (BM25, dense embeddings) menciptakan capability asymmetry terhadap LLM generator modern, dan bagaimana DecisionRAG menavigasi struktur korpus bertingkat menggunakan model keputusan (decision models) dalam konteks bersama (shared context) tanpa token generasi, menghasilkan lompatan +13.8 R@1 di MultiDoc2Dial, +17.4 Hit@1 di Natural Questions, dan latensi secepat 0.68 detik.

DynaFlow (arXiv:2610.34467): Free-Form Multi-Agent Orchestration — Sintesis Alur Kerja Eksekutabel, Eliminasi Defek Aliran Informasi, dan Lonjakan Akurasi 88.08% Tanpa Mengubah Bobot Sub-Agent
Analisis arsitektur DynaFlow (arXiv:2610.34467, Ruhao Liu et al., NUS): Mengapa topologi multi-agent statis memicu overhead komunikasi berlebihan, dan bagaimana integrasi sintesis alur kerja bebas ke dalam ruang aksi Main Agent — dikombinasikan dengan Two-Stage SFT dan kurasi 3 defek orkestrasi — menghasilkan akurasi 88.08% serta memecahkan 100% soal AIME dengan sub-agent berbobot beku.

Code Graphs & Embeddings pada Small Coding Agents (arXiv:2610.33958): Eksperimen 79k Episode SWE-bench, Gradien Hop Depth, dan Batasan Representasi Leksikal Satu-Langkah
Analisis empiris 79k episode SWE-bench Verified (arXiv:2610.33958, Saurav Bellam): Apakah tool knowledge graph dan embedding search benar-benar melengkapi pemahaman struktural coding agent kecil? Menyingkap degradasi hop gradient (odds ratio 0.50–0.67 per hop), anomali tool uptake pada model 32B, dan bukti linear probing bahwa representasi kode internal agen open-weight masih dominan bersifat leksikal satu-langkah.