DualPath: Memecahkan Storage Bandwidth Bottleneck pada Agentic Multi-Turn LLM Inference 2026
Menganalisis arsitektur DualPath (Peking University & DeepSeek-AI) yang memecahkan bottleneck storage I/O bandwidth pada pemuatan KV-Cache untuk inferensi AI Agent multi-turn dengan peningkatan throughput serving hingga 1.96x.
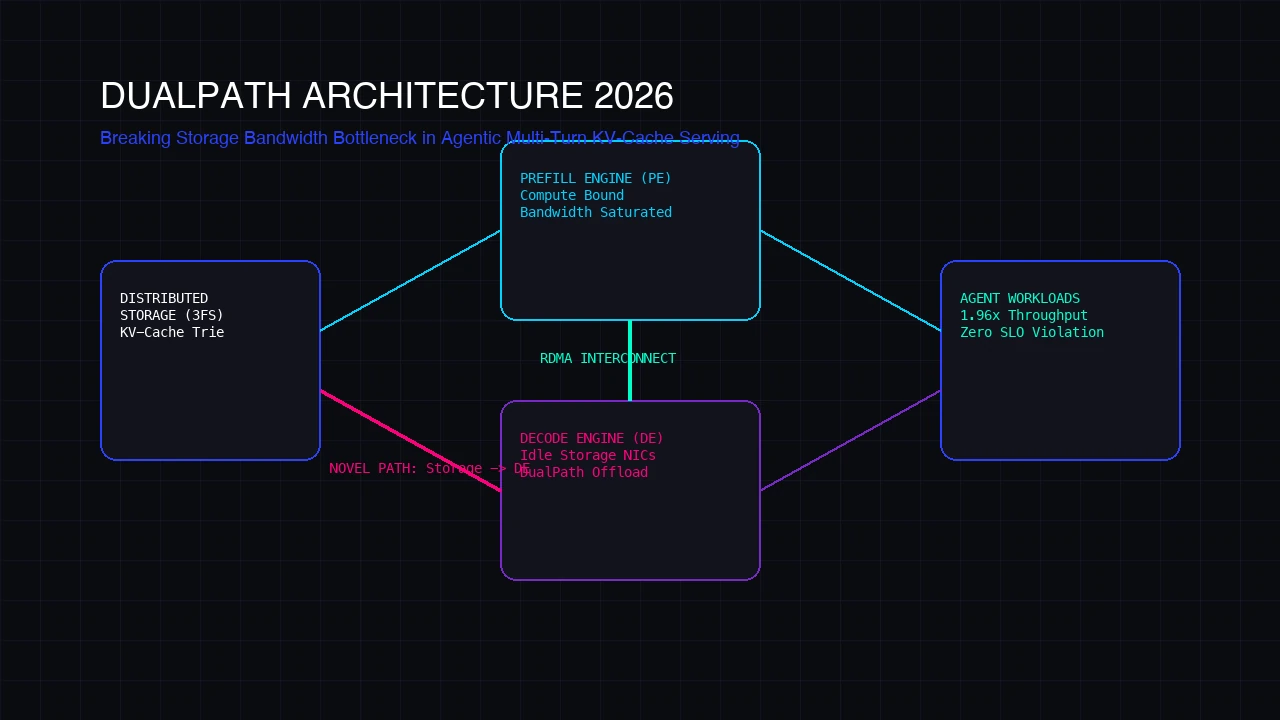
Dalam lanskap rekayasa kecerdasan buatan 2026, paradigma pemanfaatan Large Language Models (LLM) telah bergeser secara fundamental: dari sistem interaksi single-turn chatbot menjadi sistem otonom berbasis agent (agentic LLM systems). Agen otonom modern beroperasi dalam sesi interaksi multi-langkah berhorizon panjang, mengeksekusi puluhan hingga ratusan panggilan alat (tool calls), inspeksi browser, dan perbaikan kode. Konteks yang terakumulasi secara masif ini mengubah profil beban komputasi AI: inferensi tidak lagi didominasi oleh beban kalkulasi FLOPS, melainkan tertahan oleh Storage I/O Bottleneck pada pemuatan Key-Value Cache (KV-Cache).
Executive Architectural Summary & Core Finding
Pada arsitektur Prefill-Decoding Disaggregated (PD-disaggregated) konvensional, seluruh KV-Cache historis dimuat secara eksklusif oleh Prefill Engines (PE) langsung dari remote distributed storage. Hal ini memicu ketimpangan asimetris parah: Storage NIC pada Prefill Engines mengalami saturasi bandwidth 100%, sementara antarmuka jaringan storage pada Decoding Engines (DE) menganggur (idle). Riset terobosan DualPath (arXiv:2602.21548, 2026) dari peneliti Peking University, Tsinghua University, dan DeepSeek-AI memecahkan kemacetan ini melalui arsitektur dual-path KV-Cache loading. Memanfaatkan bandwidth remote storage milik Decoding Engine yang menganggur lalu mentransfernya ke Prefill Engine via RDMA over compute network meningkatkan throughput inferensi offline hingga 1.87x dan throughput serving online sebesar 1.96x tanpa melanggar SLO (Service Level Objective).
1. Anomali Beban Kerja Agentic: Mengapa KV-Cache Menjadi I/O Bound
Beban kerja inferensi agentic memiliki karakteristik yang sangat kontras jika dibandingkan dengan percakapan chat konvensional:
- Multi-Turn, Short-Append Trajectory: Pada setiap langkah pengambilan keputusan (misal: eksekusi perintah terminal atau inspeksi DOM), agen hanya menambahkan beberapa ratus token observasi baru, namun membawa puluhan ribu token riwayat percakapan sebelumnya.
- Ekstremnya Rasio KV-Cache Hit (≥ 95%): Karena konteks masa lalu bersifat deterministik, sistem inferensi modern memanfaatkan Prefix Caching. Prefill engine tidak menghitung ulang seluruh token dari awal, melainkan memuat blok KV-Cache yang sudah dihitung dari storage terdistribusi (seperti 3FS).
- Pergeseran dari Compute-Bound ke Storage-Bandwidth-Bound: Waktu prefill untuk prompt baru kini didominasi oleh waktu yang dibutuhkan kartu jaringan (NIC) untuk membaca tensor KV-Cache dari remote disk, bukan waktu komputasi GPU Tensor Core.
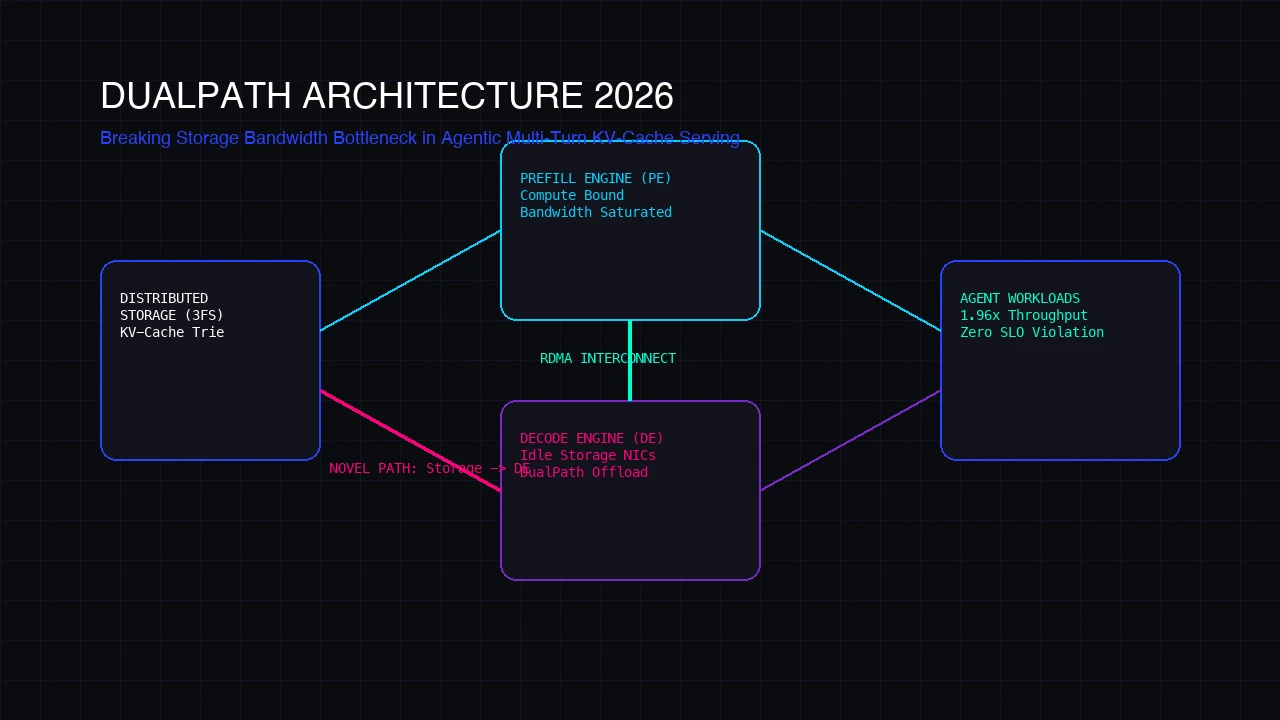
2. Asimetri Jaringan pada Arsitektur Prefill-Decoding Disaggregated
Untuk memaksimalkan efisiensi perangkat keras, industri komputasi AI memisahkan kluster menjadi dua entitas terpisah:
| Komponen Cluster | Karakteristik Komputasi | Pola Utilisasi Storage NIC | Status Bottleneck |
|---|---|---|---|
| Prefill Engine (PE) | Compute-intensive (Batch Gemm) | 100% Saturation (Membaca KV riwayat) | Critical Bottleneck |
| Decoding Engine (DE) | Memory-bandwidth-intensive (Token-by-token) | ≤ 5% Saturation (Hanya flush token baru) | Underutilized NIC Capacity |
Karena decoding engine menghasilkan token satu per satu, konsumsi bandwidth storage untuk menyimpan KV-Cache baru sangat kecil (hanya beberapa megabyte per detik per node). Sebaliknya, prefill engine harus menarik gigabyte tensor KV-Cache dalam hitungan milidetik agar TTFT (Time-to-First-Token) tetap rendah. Inilah ketimpangan fundamental yang diselesaikan oleh DualPath.
3. Arsitektur DualPath: Dual-Path Loading & Global Load Scheduler
Alih-alih memaksa seluruh pembacaan KV-Cache melewati antarmuka storage PE, DualPath membuka jalur sekunder:
- Storage-to-Decode Path: KV-Cache dari distributed storage (3FS/Lustre) dibaca oleh Decoding Engines yang memiliki bandwidth storage NIC melimpah.
- Zero-Copy RDMA Forwarding: DE langsung mentransfer blok KV-Cache ke PE menggunakan Compute Network (RDMA over Converged Ethernet / InfiniBand). Karena compute network pada kluster AI umumnya memiliki bandwidth jauh lebih masif (400Gbps - 800Gbps per GPU), transfer ini tidak menimbulkan kemacetan.
- Interference-Free Execution: DualPath menjadwalkan transfer RDMA di sela-sela iterasi decoding langkah model, memastikan transfer KV-Cache tidak menginterupsi latensi kritis pembuatan token real-time.
- Full-Block & Layer-Block Storage Layout: Menggunakan struktur Trie terdistribusi dengan format blok terpadu sehingga memory conversion tidak memerlukan overhead rekonstruksi CPU/GPU tambahan.
Implementasi Type-Safe: DualPath Routing Engine
Berikut adalah spesifikasi abstraksi dispatcher DualPath yang mengevaluasi utilisasi jaringan cluster secara dinamis:
// DualPath Dynamic KV-Cache Load Balancing & Asymmetric Route Dispatcher
export interface InferenceSessionContext {
  sessionId: string;
  turnId: number;
  kvCacheBlockIds: string[];
  totalTokens: number;
  prefillEngineBandwidthUtilization: number; // 0.0 - 1.0
  decodeEngineStorageNicIdleRate: number;    // 0.0 - 1.0
}

export interface DualPathRoutingDecision {
  route: 'DIRECT_STORAGE_TO_PREFILL' | 'DUALPATH_STORAGE_TO_DECODE_RDMA';
  estimatedTransferLatencyMs: number;
  targetDecodeNode?: string;
  rdmaChannelAllocated: boolean;
}

export class DualPathDispatcher {
  private peBandwidthThreshold = 0.85; // Ambang batas saturasi NIC Prefill

  // Evaluasi jalur pemuatan KV-Cache berdasarkan kondisi beban storage I/O real-time
  public evaluateOptimalRoute(context: InferenceSessionContext): DualPathRoutingDecision {
    const isPrefillSaturated = context.prefillEngineBandwidthUtilization > this.peBandwidthThreshold;
    const hasDecodeCapacity = context.decodeEngineStorageNicIdleRate > 0.40;

    // Jika Prefill NIC jenuh namun Decoding NIC menganggur, alihkan I/O ke jalur Decode + RDMA
    if (isPrefillSaturated && hasDecodeCapacity) {
      return {
        route: 'DUALPATH_STORAGE_TO_DECODE_RDMA',
        estimatedTransferLatencyMs: (context.totalTokens * 0.0012) + 0.45, // Zero-copy RDMA compute network
        targetDecodeNode: `de-node-${Math.floor(Math.random() * 8)}`,
        rdmaChannelAllocated: true,
      };
    }

    // Default fallback: Pemuatan langsung Storage-to-Prefill konvensional
    return {
      route: 'DIRECT_STORAGE_TO_PREFILL',
      estimatedTransferLatencyMs: context.totalTokens * 0.0038, // Terkendala bottleneck storage NIC
      rdmaChannelAllocated: false,
    };
  }
}
4. Evaluasi Kinerja & Hasil Benchmark Empiris
Dalam pengujian ekstensif menggunakan model frontier berskala besar (DeepSeek-V3, Qwen-2.5-72B, dan Qwen-32B) pada kluster produksi dengan ribuan sesi agen otonom:
5. Implikasi bagi Infrastruktur AI Enterprise Masa Depan
Peralihan menuju era autonomous agent menuntut rekayasa ulang pada lapisan inferensi sistem. Mengasumsikan bahwa performa LLM semata-mata ditentukan oleh jumlah FLOPs GPU adalah kekeliruan besar pada beban kerja interaktif multi-turn. Arsitektur DualPath membuktikan bahwa orkestrasi asimetris antara storage NIC dan compute RDMA mampu melipatgandakan kapasitas serving tanpa memerlukan belanja modal (CapEx) perangkat keras komputasi baru.
Butuh Arsitektur Web & AI Berkualitas Tinggi?
Tim engineering NEWSAINT siap membantu merancang website berkecepatan tinggi, sistem AI autonomous, dan solusi SaaS terukur untuk bisnis Anda.
Artikel Terkait Lainnya

DecisionRAG (arXiv:2610.35868): Retriever-Free Retrieval via Decision Models — Eliminasi Capability Asymmetry, Hierarchical Tree Navigation, dan Rekor +17.4% Hit@1 Tanpa Indeks Vektor
Analisis arsitektur DecisionRAG (arXiv:2610.35868, Chao Wan, Paul Jünger, Beixi Du, Bodong Liu, Navaneetha Krishnan, Kilian Q. Weinberger — Cornell University & ASAPP): Mengapa retrieval konvensional (BM25, dense embeddings) menciptakan capability asymmetry terhadap LLM generator modern, dan bagaimana DecisionRAG menavigasi struktur korpus bertingkat menggunakan model keputusan (decision models) dalam konteks bersama (shared context) tanpa token generasi, menghasilkan lompatan +13.8 R@1 di MultiDoc2Dial, +17.4 Hit@1 di Natural Questions, dan latensi secepat 0.68 detik.

DynaFlow (arXiv:2610.34467): Free-Form Multi-Agent Orchestration — Sintesis Alur Kerja Eksekutabel, Eliminasi Defek Aliran Informasi, dan Lonjakan Akurasi 88.08% Tanpa Mengubah Bobot Sub-Agent
Analisis arsitektur DynaFlow (arXiv:2610.34467, Ruhao Liu et al., NUS): Mengapa topologi multi-agent statis memicu overhead komunikasi berlebihan, dan bagaimana integrasi sintesis alur kerja bebas ke dalam ruang aksi Main Agent — dikombinasikan dengan Two-Stage SFT dan kurasi 3 defek orkestrasi — menghasilkan akurasi 88.08% serta memecahkan 100% soal AIME dengan sub-agent berbobot beku.

Code Graphs & Embeddings pada Small Coding Agents (arXiv:2610.33958): Eksperimen 79k Episode SWE-bench, Gradien Hop Depth, dan Batasan Representasi Leksikal Satu-Langkah
Analisis empiris 79k episode SWE-bench Verified (arXiv:2610.33958, Saurav Bellam): Apakah tool knowledge graph dan embedding search benar-benar melengkapi pemahaman struktural coding agent kecil? Menyingkap degradasi hop gradient (odds ratio 0.50–0.67 per hop), anomali tool uptake pada model 32B, dan bukti linear probing bahwa representasi kode internal agen open-weight masih dominan bersifat leksikal satu-langkah.