CoPE (arXiv:2610.20597): Co-Evolving Acting and Forecasting for Language Agents, Multi-Step Action Targets, dan Eliminasi Overhead Inferensi pada Long-Horizon Agentic RL
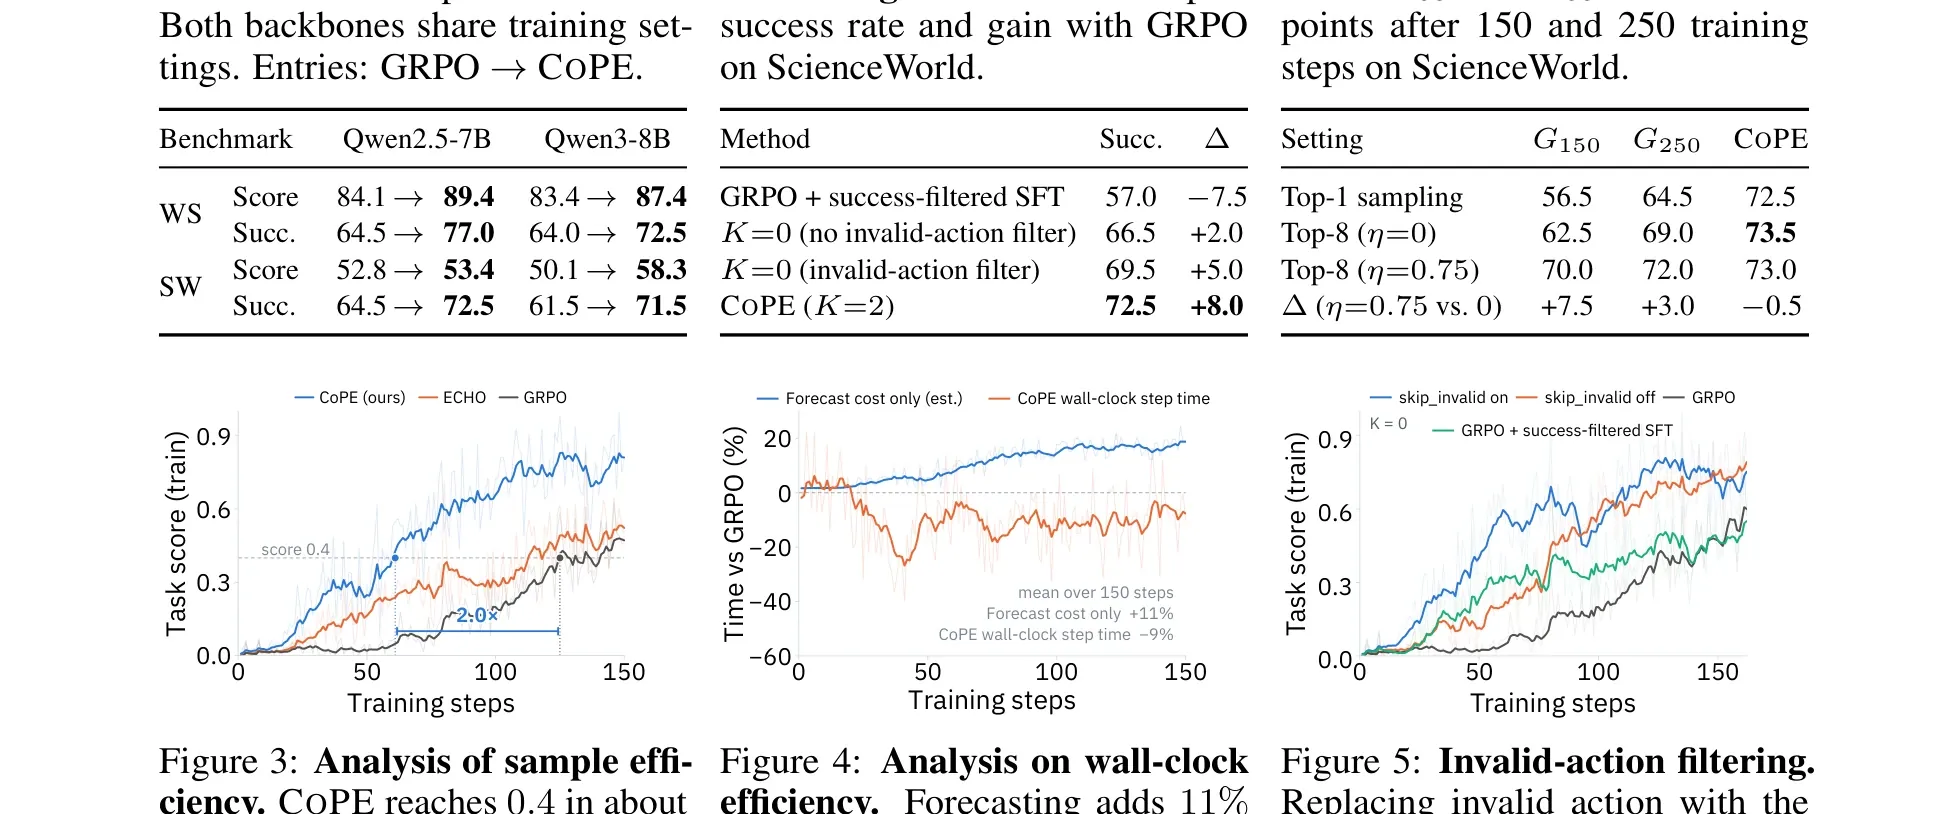
Analisis mendalam riset frontier arXiv:2610.20597 (Haofei Yu, Yixing Chen, Yining Zhao, Xuyan Ye, Yuxiang Liu, Zhigang Hua, Yan Xie, Shuang Yang, Jiaxuan You — UIUC, UC San Diego, Meta AI): Memecahkan kemacetan efisiensi sampel pada pelatihan agen bahasa otonom. Berbeda dari RL agen standar (GRPO) yang hanya mengandalkan reward skalar terminal di akhir trajektori, serta melompati pendekatan prediksi observasi (ECHO, RWML) yang rentan noise dan berhorizon 1 langkah, CoPE memperkenalkan multi-step action targets q(a_{t:t+K} | h_t) pada trajektori sukses (Y=1). Melalui parameter sharing tunggal, CoPE menyatukan kebijakan acting pi_theta dan forecasting p_theta, menciptakan ensemble temporal implisit yang diserap representasi model. Evaluasi pada 5 benchmark (ALFWorld, ScienceWorld, WebShop, tau^2-bench, dan AppWorld) membuktikan peningkatan efisiensi sampel hingga 2.0x dibanding GRPO, mengungguli baseline RL tanpa memerlukan model terpisah, pretraining tambahan, ataupun overhead inferensi (zero inference overhead).
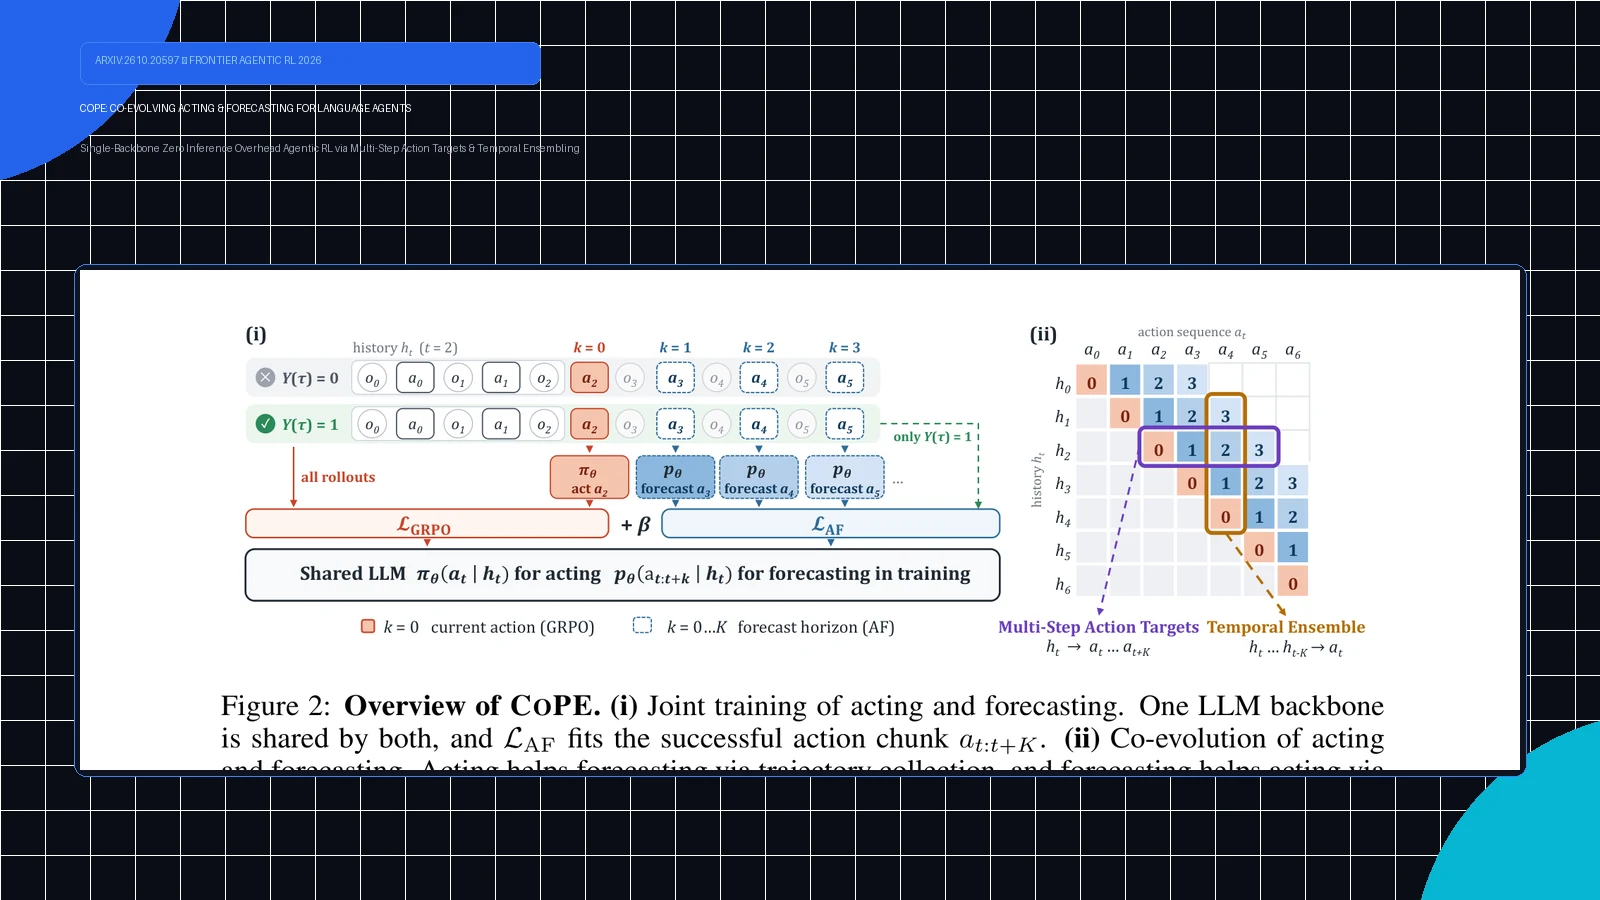
Riset frontier terbaru dari tim kolaborasi University of Illinois Urbana-Champaign (UIUC), University of California San Diego (UCSD), dan Meta AI (Haofei Yu, Yixing Chen, Yining Zhao, Xuyan Ye, Yuxiang Liu, Zhigang Hua, Yan Xie, Shuang Yang, Jiaxuan You) memperkenalkan CoPE (Co-Evolving Acting and Forecasting for Language Agents): algoritma Reinforcement Learning (RL) terobosan yang memecahkan hambatan efisiensi sampel pada agen otonom berhorizon panjang melalui target multi-step action forecast, temporal ensembling implisit, serta eliminasi total terhadap overhead inferensi.
1. Paradoks Eksplorasi: Mengapa Agentic RL Konvensional Sangat Boros Komputasi?
Melatih agen berbasis model bahasa besar (LLM) untuk menyelesaikan tugas rekayasa berhorizon panjang—seperti investigasi perbaikan software (SWE-bench), eksekusi API multi-aplikasi (AppWorld), navigasi web multi-hop (WebShop), hingga penalaran sains (ScienceWorld)—selama ini terbentur oleh biaya roll-out lingkungan yang luar biasa mahal.
Berbeda dengan fine-tuning instruksi statis, setiap roll-out agen membutuhkan interaksi interaktif berulang kali ke dalam sandbox runtime: mengeksekusi shell terminal, membaca ratusan baris response HTTP, dan merender DOM. Namun, paradigma Group Relative Policy Optimization (GRPO) standar hanya mengekstrak satu sinyal skalar biner di ujung akhir trajektori ($Y in {0, 1}$): apakah agen berhasil atau gagal.
Konsekuensinya, jutaan token observasi dan ratusan keputusan aksi perantara (intermediate steps) terbuang sia-sia tanpa supervisi terarah. Upaya riset sebelumnya berusaha menambahkan sinyal supervisi perantara melalui dua mazhab, namun keduanya memiliki cacat intrinsik yang fatal:
Mengestimasi probabilitas sukses per langkah melalui model critic. Masalah mendasar: semua target nilai berasal dari satu sinyal skalar tunggal yang sama di akhir trajektori, menyebabkan varians estimasi yang sangat tinggi dan ketidakstabilan konvergensi pada lingkungan sparse-reward.
Memaksa model memprediksi respon lingkungan berikutnya (next-observation prediction). Masalah mendasar: observasi lingkungan (halaman HTML, log compiler, stack trace ribuan baris) sangat bising, masif, dan secara komputasi hanya mampu memprediksi 1 langkah ke depan ($K=1$), gagal menangkap rencana jangka panjang.
2. Arsitektur CoPE: Mengawinkan Acting dan Multi-Step Forecasting dalam Satu Backbone
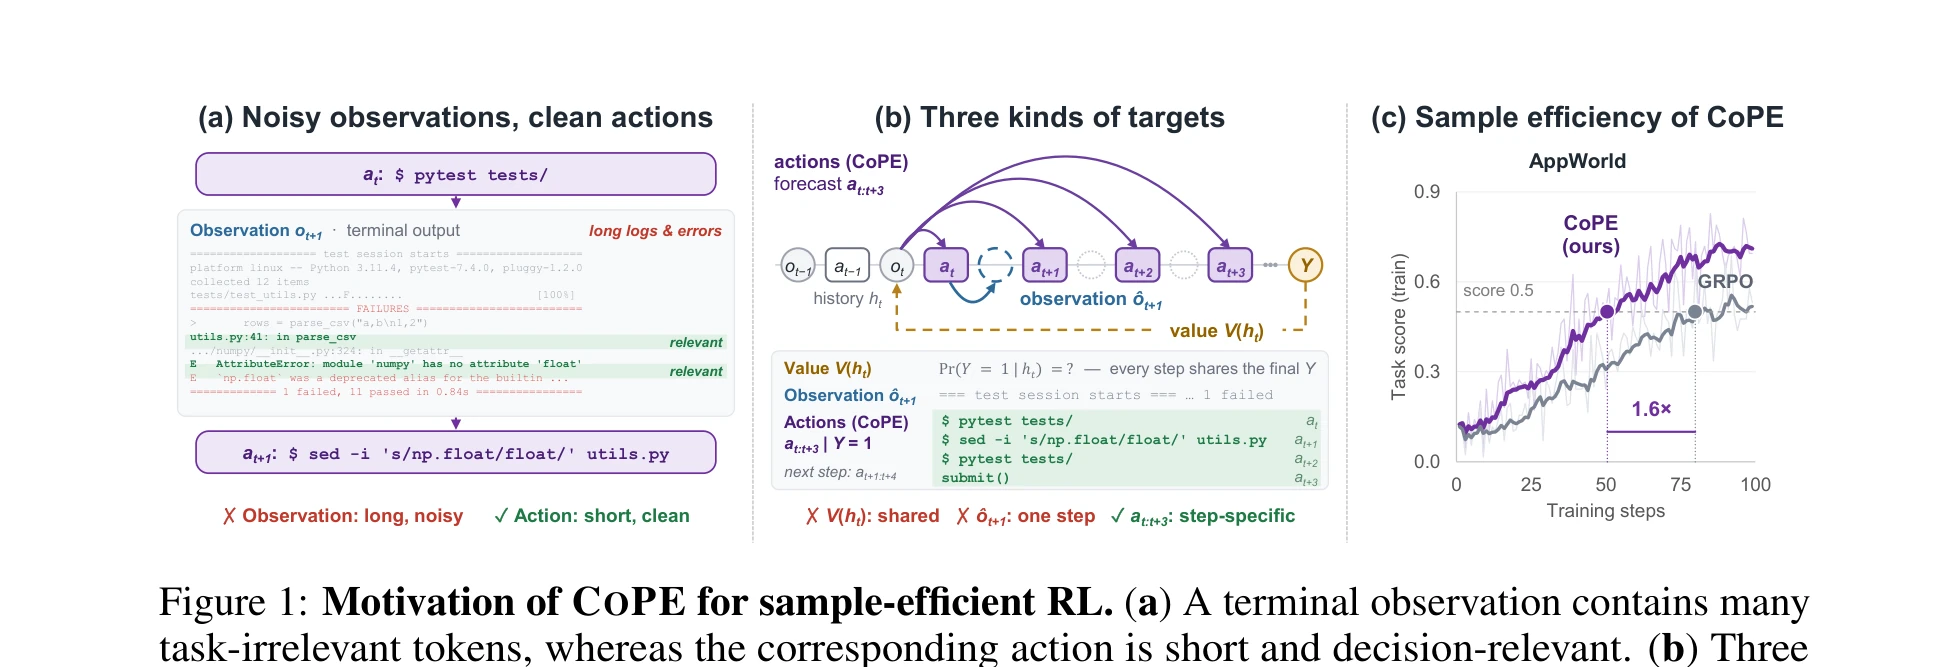
Untuk mengatasi kebuntuan tersebut, CoPE memperkenalkan kategori supervisi ketiga: Multi-Step Action Targets. Inti dari gagasan ini adalah melatih satu representasi model bahasa yang sama untuk bertindak pada saat ini ($pi_ heta$) sekaligus meramalkan rentetan $K$ aksi berikutnya ($p_ heta$) yang terbukti menghasilkan keberhasilan.
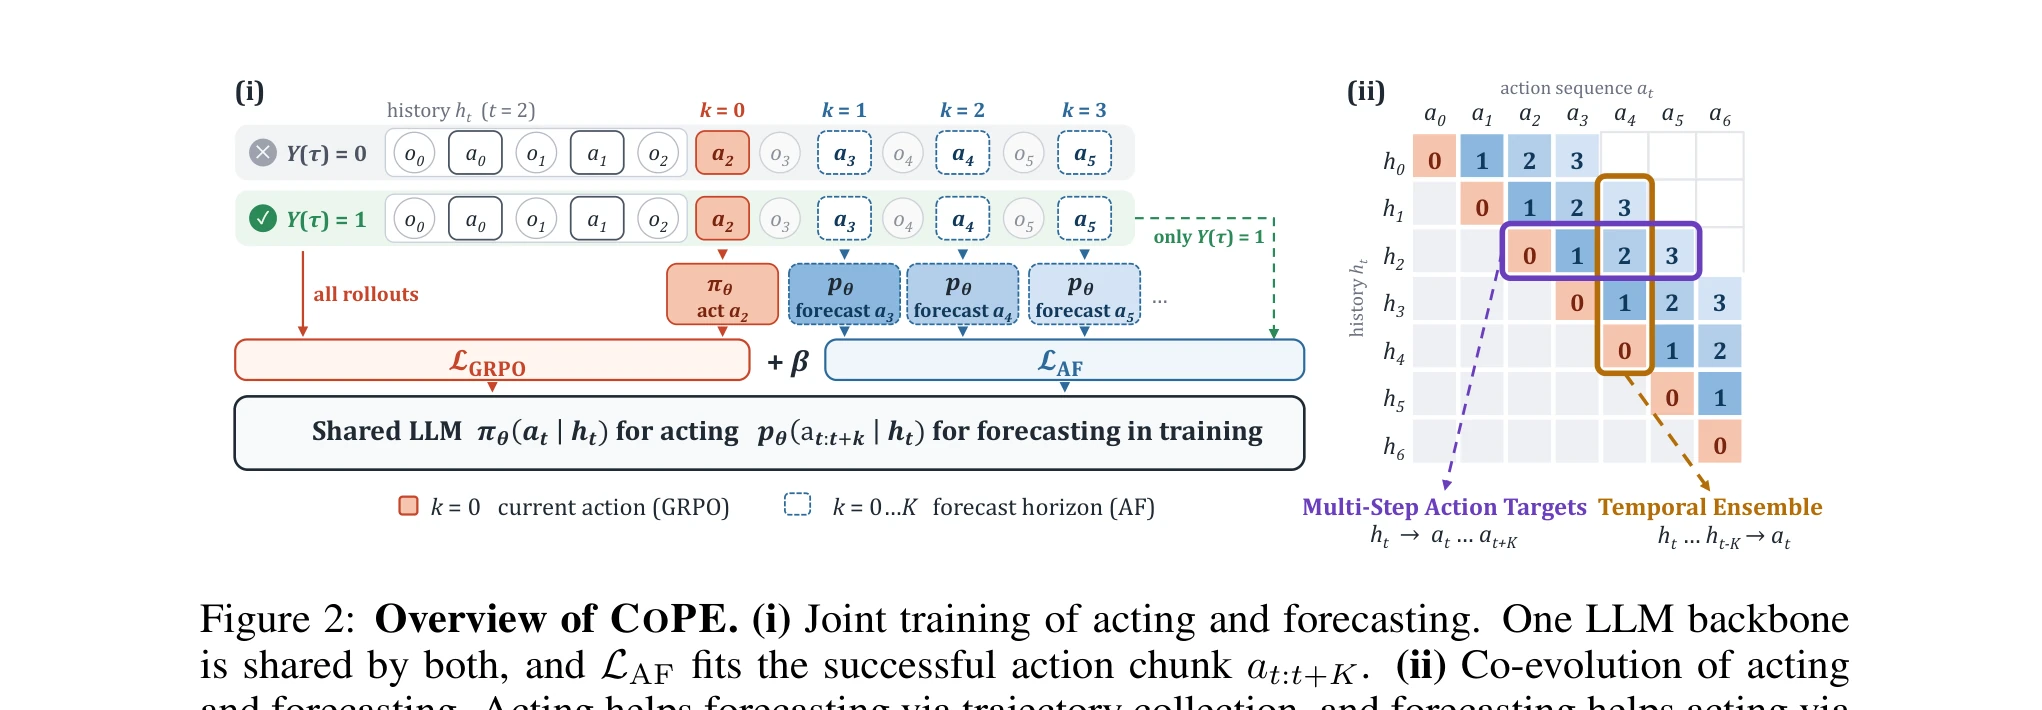
3. Landasan Teoretis: Success-Conditioned Action Chunks & GRPO Equivalence
Misalkan $pi$ adalah kebijakan rollout, $Y in {0, 1}$ adalah indikator keberhasilan, dan $mathrm{Pr}^+ riangleq mathrm{Pr}^pi(cdot mid Y=1)$ merepresentasikan distribusi trajektori yang sukses.
Diberikan riwayat interaksi $h_t$, success-conditioned action chunk $q(a_{t:t+K} mid h_t)$ didefinisikan sebagai distribusi sekuens $K+1$ aksi masa depan pada roll-out sukses, di mana observasi lingkungan perantara telah dimarjinalkan secara natural oleh lingkungan fisik:
Mengapa GRPO Sebenarnya Hanya Melakukan Single-Step Fitting ($K=0$)?
Dalam analisis ideal on-policy GRPO (tanpa pembatasan kliping dan tanpa penalti KL), skor reward memiliki ekspektasi nol. Mendorong turun probabilitas roll-out yang gagal mengarah pada vektor gradien ekspektasi yang sama dengan menarik naik roll-out yang berhasil. Efektif loss GRPO dapat dituliskan sebagai:
Dengan demikian, GRPO standar hanya melatih kebijakan $pi_ heta$ mencocokkan distribusi satu langkah saja ($K=0$) dan tidak pernah menuntut representasi $h_t$ untuk mengantisipasi aksi berikutnya.
Action Forecasting Loss untuk Multi-Step Chunks ($K > 0$)
CoPE memperluas target tersebut ke horizon $K$ melalui model autoregresif $p_ heta(a_{t:t+K} mid h_t) = prod_{k=0}^K p_ heta(a_{t+k} mid h_t, a_{t:t+k-1})$ dengan loss:
Keunggulan matematis luar biasa dari pendekatan ini adalah: kita tidak perlu mempelajari world model terpisah untuk mensimulasikan masa depan lingkungan. Trajektori sukses lingkungan fisik secara otomatis memberikan sampel murni dari $q(a_{t:t+K} mid h_t)$ dengan observasi perantara yang sudah terintegrasi secara eksak.
4. Group Normalization & Dinamika Ko-Evolusi Simbiotik
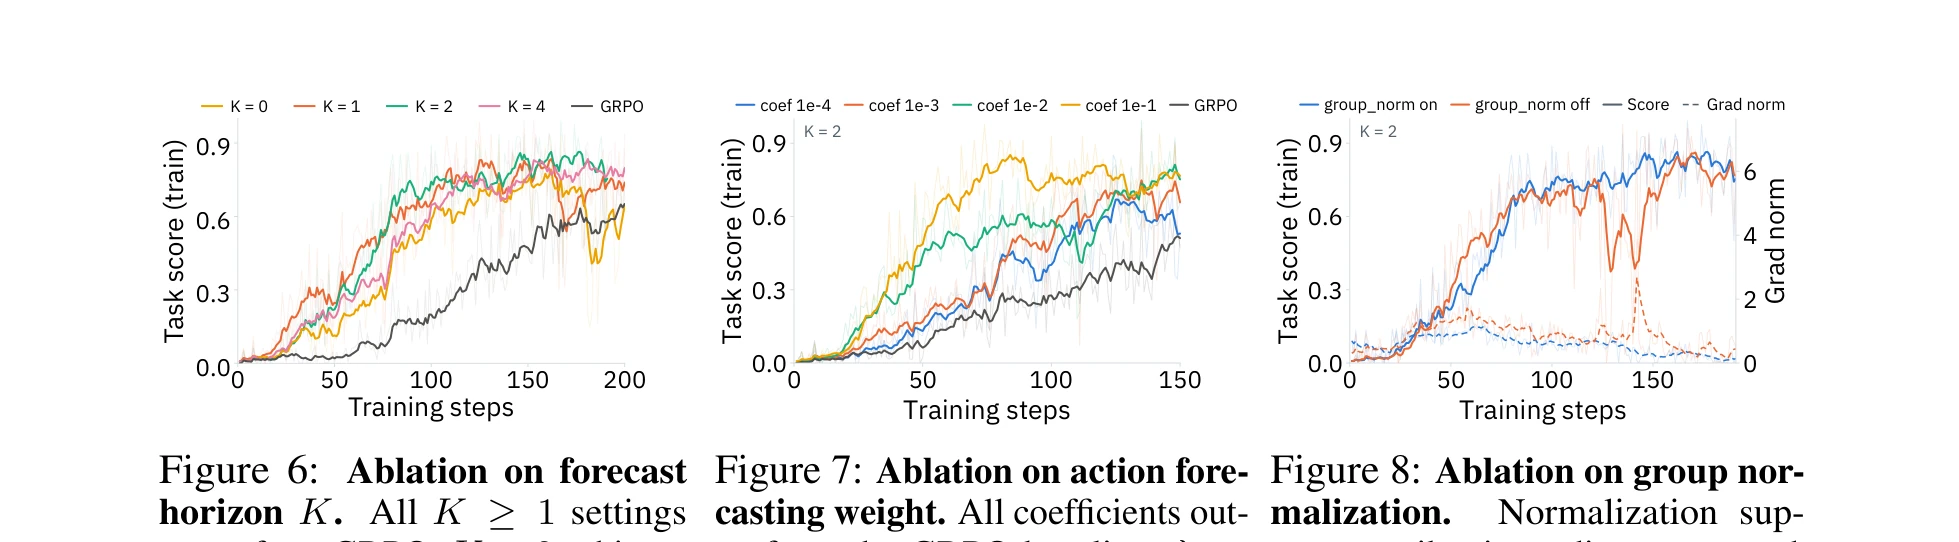
Salah satu jebakan terbesar saat menggabungkan loss supervised ke dalam loop RL adalah pergeseran skala gradien. Seiring membaiknya kebijakan, jumlah trajektori sukses dalam kelompok sampel ($|S_x|$) melonjak. Jika tidak dinormalisasi, gradien peramalan aksi akan mendominasi dan mengacaukan optimasi kebijakan.
CoPE merumuskan fungsi loss objektif kelompok secara presisi dengan faktor penimbang kelompok:
Pembagian dengan $max(1, |S_x|)$ menghapus ketergantungan linier pada jumlah sukses, menjaga stabilitas norm gradien sepanjang seluruh siklus pelatihan hingga ratusan iterasi.
5. Evaluasi Kinerja Empiris pada 5 Benchmark Agen Mandiri
CoPE diuji secara ketat pada 5 lingkungan uji agen berhorizon panjang dengan ruang observasi dan kompleksitas aksi yang sangat heterogen: ALFWorld (household tasks), WebShop (e-commerce visual-textual web navigation), ScienceWorld (scientific deduction), $ au^2$-bench (multi-turn airline/retail customer service), dan AppWorld (perakitan kode API multi-aplikasi dunia nyata).
| Metode & Model Backbone | ALFWorld (All) | WebShop (Score / Succ.) | ScienceWorld (Score / Succ.) | AppWorld (Normal / Chall.) |
|---|---|---|---|---|
| GPT-5.5 (Agentic Prompting) | 93.5% | 66.1 / 56.5% | 66.8 / 79.0% | - |
| Qwen2.5-7B + Reflexion | 54.0% | 21.9 / 4.0% | -3.7 / 6.0% | 10.7 / 2.6% |
| RFT (Rejection Sampling Fine-Tuning) | 77.0% | 51.4 / 16.0% | -11.0 / 4.5% | - |
| Standard GRPO (DeepSeek) | 90.5% | 84.1 / 64.5% | 52.8 / 64.5% | 41.7 / 18.7% |
| RWML + GRPO (Next-State Auxiliary) | 92.0% | 81.2 / 64.0% | 39.4 / 65.0% | - |
| ECHO (Next-Observation Target) | 94.5% | 85.0 / 71.5% | 44.8 / 67.5% | - |
| CoPE (Ours, Single Backbone) SOTA | 95.5% | 89.4 / 77.0% | 53.4 / 72.5% | 55.4 / 22.5% |
6. Spesifikasi Engine Produksi: TypeScript Trajectory & Policy Loss Specification
Bagi tim rekayasa platform yang mengintegrasikan pipeline Reinforcement Learning mandiri pada harness agen otonom, berikut adalah modul inti spesifikasi logika CoPE:
${COPE_CODE_SNIPPET}7. Blueprint Rekayasa Sistem Agen AI 2026: Implikasi Strategis bagi Praktisi
Hasil temuan makalah CoPE membawa empat paradigma fundamental bagi pengembangan agen masa depan:
- Hentikan Pemborosan Komputasi pada World Model Observasi yang Berat: Memaksa model memprediksi keluaran terminal atau DOM halaman web adalah distraksi yang tidak efisien karena ruang status observasi dipenuhi noise yang tidak relevan dengan intensi tugas. Memprediksi chunk aksi sukses masa depan jauh lebih padat informasi dan langsung berorientasi pada penyelesaian sasaran.
- Zero Inference Overhead adalah Kunci Skalabilitas Produksi: Banyak metode penelitian menuntut arsitektur multi-agen kompleks, tree search berat (MCTS), atau sampling verifier berulang saat deployment. CoPE membuktikan bahwa seluruh kecerdasan peramalan dapat dipadatkan ke dalam bobot model selama fase training, sehingga saat di-deploy ke pengguna, agen beroperasi satu langkah per langkah tanpa penalti latensi 1 milidetik pun.
- Terapkan Group Normalization pada Semua Auxiliary Loss RLVR: Saat melatih model internal dengan reward otomatis (RL with Verifiable Rewards), jangan pernah membiarkan loss proses berskala linier terhadap jumlah roll-out sukses. Normalisasi kelompok adalah pelindung mutlak terhadap gradient explosion saat model mulai mencapai fase konvergensi.
- Manfaatkan Sinergi Antara Hierarki Opsi (LAGO) dan Pelatihan CoPE: Kombinasi ideal arsitektur otonom 2026 adalah menggunakan dekomposisi hierarkis pada level makro (seperti LAGO options) untuk mengisolasi boundary konteks, dipadukan dengan kebijakan mikro teroptimasi CoPE untuk memastikan setiap sub-agen mengeksekusi urutan tool dengan presisi setinggi mungkin.
Referensi & Sumber Terverifikasi
- [1]Co-Evolving Acting and Forecasting for Language Agents(arXiv:2610.20597 [cs.AI, cs.LG] — Haofei Yu, Yixing Chen, Yining Zhao, Xuyan Ye, Yuxiang Liu, Zhigang Hua, Yan Xie, Shuang Yang, Jiaxuan You (UIUC, UC San Diego, Meta AI))
- [2]DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models (GRPO Formulation)(arXiv:2402.03300 — Zhihong Shao, Peiyi Wang, Qihao Zhu, Runxin Xu, Junxiao Song, Mingchuan Zhang, Y.K. Li, Y. Wu, Daya Guo)
- [3]ECHO: Environment-Conditioned Hindsight Observation Objectives for Agentic RL(arXiv:2603.11928 — Kumar Shrivastava, Rishabh Agarwal et al.)
- [4]AppWorld: A Controllable World of Apps and People for Benchmarking Interactive Coding Agents(ACL 2024 / arXiv:2407.18901 — Harsh Trivedi, Tushar Khot, Balaji V. Srinivasan et al.)
- [5]tau^2-bench: Evaluating Policy-Constrained Customer Service Multi-Turn Tool Agents(arXiv:2506.08912 — Barres et al.)
- [6]ScienceWorld: Is Your Agent Smarter than a 5th Grader?(EMNLP 2022 — Ruoyao Wang, Peter Jansen et al.)
- [7]LAGO: Language Agents with Reusable Growing Options (arXiv:2610.19843)(NEWSAINT Frontier AI Systems Review / arXiv:2610.19843)
- [8]Co-Evolving Acting and Forecasting for Language Agents(arXiv:2610.20597 [cs.AI, cs.LG] — Haofei Yu, Yixing Chen, Yining Zhao, Xuyan Ye, Yuxiang Liu, Zhigang Hua, Yan Xie, Shuang Yang, Jiaxuan You (UIUC, UC San Diego, Meta AI))
- [9]DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models (GRPO Formulation)(arXiv:2402.03300 — Zhihong Shao, Peiyi Wang, Qihao Zhu, Runxin Xu, Junxiao Song, Mingchuan Zhang, Y.K. Li, Y. Wu, Daya Guo)
- [10]ECHO: Environment-Conditioned Hindsight Observation Objectives for Agentic RL(arXiv:2603.11928 — Kumar Shrivastava, Rishabh Agarwal et al.)
- [11]AppWorld: A Controllable World of Apps and People for Benchmarking Interactive Coding Agents(ACL 2024 / arXiv:2407.18901 — Harsh Trivedi, Tushar Khot, Balaji V. Srinivasan et al.)
- [12]tau^2-bench: Evaluating Policy-Constrained Customer Service Multi-Turn Tool Agents(arXiv:2506.08912 — Barres et al.)
- [13]ScienceWorld: Is Your Agent Smarter than a 5th Grader?(EMNLP 2022 — Ruoyao Wang, Peter Jansen et al.)
- [14]LAGO: Language Agents with Reusable Growing Options (arXiv:2610.19843)(NEWSAINT Frontier AI Systems Review / arXiv:2610.19843)
Butuh Arsitektur Web & AI Berkualitas Tinggi?
Tim engineering NEWSAINT siap membantu merancang website berkecepatan tinggi, sistem AI autonomous, dan solusi SaaS terukur untuk bisnis Anda.
Artikel Terkait Lainnya

DecisionRAG (arXiv:2610.35868): Retriever-Free Retrieval via Decision Models — Eliminasi Capability Asymmetry, Hierarchical Tree Navigation, dan Rekor +17.4% Hit@1 Tanpa Indeks Vektor
Analisis arsitektur DecisionRAG (arXiv:2610.35868, Chao Wan, Paul Jünger, Beixi Du, Bodong Liu, Navaneetha Krishnan, Kilian Q. Weinberger — Cornell University & ASAPP): Mengapa retrieval konvensional (BM25, dense embeddings) menciptakan capability asymmetry terhadap LLM generator modern, dan bagaimana DecisionRAG menavigasi struktur korpus bertingkat menggunakan model keputusan (decision models) dalam konteks bersama (shared context) tanpa token generasi, menghasilkan lompatan +13.8 R@1 di MultiDoc2Dial, +17.4 Hit@1 di Natural Questions, dan latensi secepat 0.68 detik.

DynaFlow (arXiv:2610.34467): Free-Form Multi-Agent Orchestration — Sintesis Alur Kerja Eksekutabel, Eliminasi Defek Aliran Informasi, dan Lonjakan Akurasi 88.08% Tanpa Mengubah Bobot Sub-Agent
Analisis arsitektur DynaFlow (arXiv:2610.34467, Ruhao Liu et al., NUS): Mengapa topologi multi-agent statis memicu overhead komunikasi berlebihan, dan bagaimana integrasi sintesis alur kerja bebas ke dalam ruang aksi Main Agent — dikombinasikan dengan Two-Stage SFT dan kurasi 3 defek orkestrasi — menghasilkan akurasi 88.08% serta memecahkan 100% soal AIME dengan sub-agent berbobot beku.

Code Graphs & Embeddings pada Small Coding Agents (arXiv:2610.33958): Eksperimen 79k Episode SWE-bench, Gradien Hop Depth, dan Batasan Representasi Leksikal Satu-Langkah
Analisis empiris 79k episode SWE-bench Verified (arXiv:2610.33958, Saurav Bellam): Apakah tool knowledge graph dan embedding search benar-benar melengkapi pemahaman struktural coding agent kecil? Menyingkap degradasi hop gradient (odds ratio 0.50–0.67 per hop), anomali tool uptake pada model 32B, dan bukti linear probing bahwa representasi kode internal agen open-weight masih dominan bersifat leksikal satu-langkah.