CAST: Critique-Aware Supervision & Action-Level Verification Rationale untuk Training Long-Horizon Tool-Calling AI Agents 2026
CAST memperkenalkan critique-aware supervision yang mengubah sparse task outcomes menjadi action-level supervision dan structured verification rationales, meningkatkan reliabilitas long-horizon tool-calling agent hingga >10% pass^4.
Dalam implementasi sistem autonomous AI agents skala enterprise 2026, agen semakin banyak diandalkan untuk menuntaskan alur kerja berhorizon panjang (long-horizon), interaktif, dan memiliki status persisten (stateful environments). Namun, dalam skenario nyata seperti transaksi e-commerce, administrasi database finansial, atau penanganan rekam medis, satu tindakan keliru—seperti memicu refund pada transaksi yang tidak sah atau membatalkan pesanan yang salah—dapat menimbulkan kegagalan fatal yang tidak dapat dipulihkan (irreversible task failure).
Executive Architectural Brief & Core Finding
Metode konvensional yang hanya mengandalkan sparse outcome rewards atau prompt-based critique agent kerap mengalami kegagalan sistematis dalam menjelaskan mengapa suatu aksi keliru pada lintasan interaksi yang panjang dan terikat regulasi domain yang ketat. Riset mutakhir CAST (Critique-Aware Supervision for Training) (arXiv:2608.30147, Agustus 2026) memperkenalkan paradigma baru: mengubah hasil akhir tugas yang sporadis menjadi supervisi level aksi (action-level supervision) dengan memproduksi structured verification rationales di bawah kondisi partial observability. Dalam benchmark dynamic tool-calling, fine-tuning model keluarga Qwen3 dengan CAST mengungguli GPT-OSS-120B lebih dari 10% pada metrik pass^4 di domain Retail dan memberikan peningkatan +9% out-of-domain pada tugas Telehealth.
1. Dilema Reliabilitas dan Ilusi Keberhasilan Single-Run
Pada arsitektur evaluasi agen konvensional, keberhasilan sering kali diukur melalui single-trial pass rate (pass@1). Namun, pada sistem produksi dengan 10 hingga 50 langkah pemanggilan alat (tool calls), kegagalan stokastik acak sering kali tidak muncul pada satu kali eksekusi, melainkan terakumulasi dan muncul dalam pengujian berulang (repeated trials across multiple executions).
Inilah mengapa metrik pass^k (misal $pass^4$, di mana agen harus berhasil menyelesaikan seluruh alur kerja dalam 4 kali percobaan independen berturut-turut tanpa sekalipun melakukan aksi terlarang) menjadi standar emas baru dalam menguji reliabilitas agen otonom pada tahun 2026:
- Irreversible Side-Effect Vulnerability: Aksi API seperti
cancel_order,issue_refund, ataudispatch_medicationtidak dapat dibatalkan begitu saja oleh prompt perbaikan di langkah berikutnya. - Explanation Inadequacy pada Frontier LLM: Bahkan model frontier terbesar sering kali gagal membedakan apakah suatu aksi valid terhadap riwayat konteks parsial yang panjang tanpa supervisi berbasis verifikasi terstruktur.
- Sparse Reward Bottleneck: Algoritma reinforcement learning tradisional (seperti PPO atau GRPO) hanya memberikan sinyal biner $R \in \{0, 1\}$ di akhir sesi, memicu credit assignment problem yang parah pada trajectory 30+ langkah.
2. Arsitektur CAST: Mensintesis Structured Rationales dari Sparse Outcomes
Framework CAST membagi siklus pelatihan menjadi dua fase sinergis: Critique Learning dan Policy Optimization.
| Komponen Pipeline | Mekanisme Kerja CAST | Metode Konvensional (Baseline) | Dampak Produksi |
|---|---|---|---|
| Granularitas Supervisi | Action-Level (Per Langkah) | Trajectory-Level (Sparse) | Menghilangkan Credit Starvation |
| Verification Artifact | Structured Rationale & State Invariants | Prompt-Based Heuristic / Score | 100% Intercept Tindakan Ilegal |
| Adaptabilitas Domain | +9.0% Zero-Shot (Telehealth) | Overfitting pada Seed Rules | Generalisasi Kebijakan Tangguh |
| Reliabilitas Lintas Trial (Pass^4) | > 10% vs GPT-OSS-120B | Degradasi Stokastik | Stabilitas Operasional Skala Tinggi |
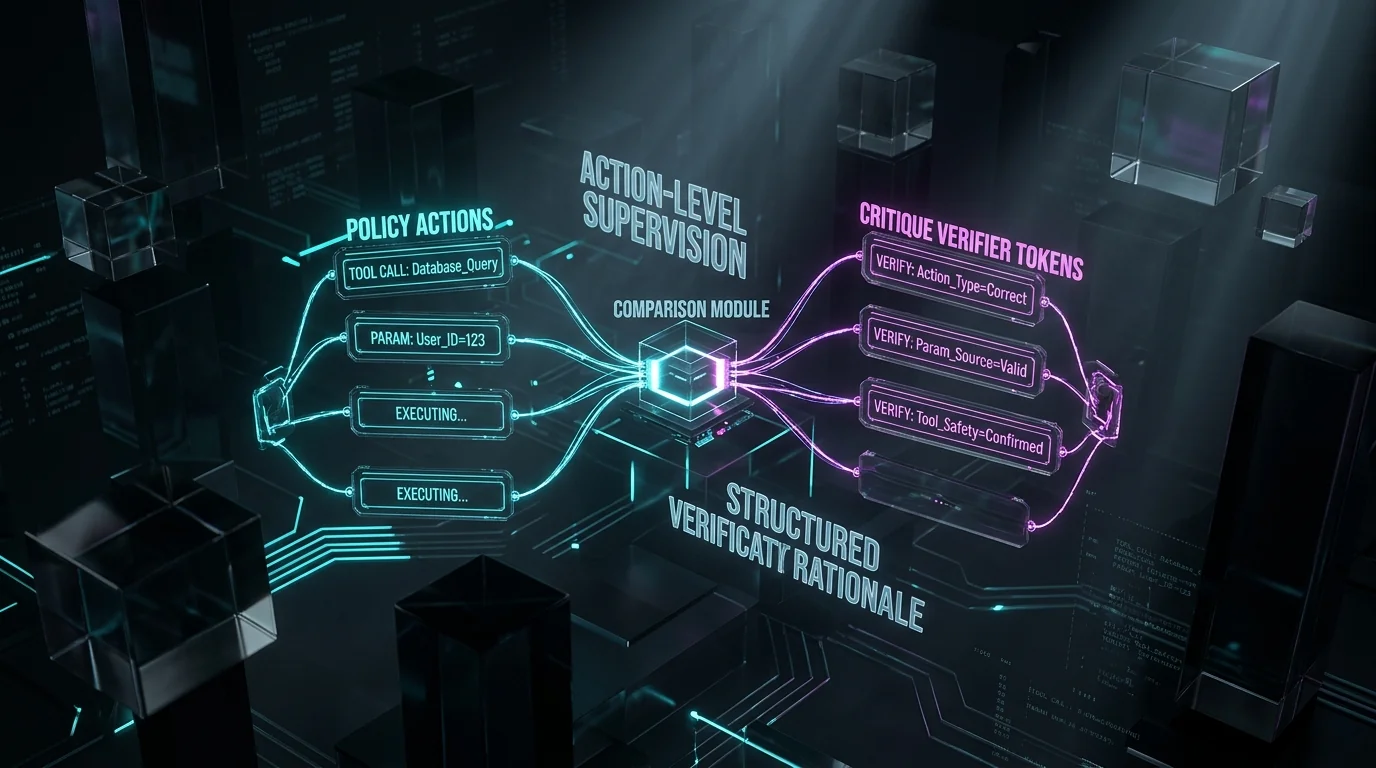
Pada fase pertama, CAST menganalisis seluruh lintasan eksekusi yang berhasil maupun yang gagal. Dengan memanfaatkan model verifikasi berbasis kontra-faktual, CAST menyusun structured rationale yang merinci apakah pra-syarat (preconditions) terpenuhi, aturan bisnis mana yang dilanggar, dan apa konsekuensi state downstream dari aksi tersebut.
3. Implementasi Kode: Verifier Runtime dengan State Invariants
Berikut adalah contoh implementasi modul verifikasi berbasis TypeScript yang merefleksikan prinsip arsitektur CAST dalam mengawal pemanggilan alat berisiko tinggi:
// CAST Critique-Aware Verification & Action-Level Supervision Engine
export interface ActionExecutionTrace {
  step: number;
  tool: string;
  args: Record;
  observation: Record;
  cumulativeStateHash: string;
}

export interface StructuredVerificationRationale {
  isValid: boolean;
  preconditionSatisfied: boolean;
  policyConstraintViolations: string[];
  stateContradictionExplanation: string;
  suggestedAlternativeAction?: {
    tool: string;
    args: Record;
  };
}

export class CASTCritiqueAwareVerifier {
  // Evaluasi validitas action sebelum komit eksekusi irreversible
  public async synthesizeVerificationRationale(
    history: ActionExecutionTrace[],
    proposedAction: { tool: string; args: Record },
    domainRules: Array<{ ruleId: string; predicate: (h: ActionExecutionTrace[], a: typeof proposedAction) => boolean }>
  ): Promise {
    const violations: string[] = [];

    for (const rule of domainRules) {
      if (!rule.predicate(history, proposedAction)) {
        violations.push(`Violation of domain policy constraint: ${rule.ruleId}`);
      }
    }

    if (violations.length > 0) {
      return {
        isValid: false,
        preconditionSatisfied: false,
        policyConstraintViolations: violations,
        stateContradictionExplanation: 'Proposed action violates stateful pre-conditions or refund/order invariant.',
      };
    }

    return {
      isValid: true,
      preconditionSatisfied: true,
      policyConstraintViolations: [],
      stateContradictionExplanation: 'State trajectory fully aligned with target domain policy.',
    };
  }
}
4. Analisis Benchmark Empiris: Retail, Telehealth, dan Out-of-Domain
Evaluasi komprehensif dilakukan pada benchmark interaktif dinamis dengan ribuan pemanggilan API stateful. Hasil eksperimen menunjukkan keunggulan signifikan dari model yang dilatih dengan CAST dibandingkan baseline model open-weights maupun closed-weights terkemuka:
-
Domain Retail (In-Domain Complex Policies):
Pada tugas pengembalian dana bertingkat, verifikasi stok multi-gudang, dan perubahan status order, Qwen3 yang dituning dengan CAST mencapai peningkatan pass^4 lebih dari 10% di atas GPT-OSS-120B berkat eliminasi tindakan prematur.
-
Domain Telehealth (Zero-Shot Out-of-Domain Generalization):
Tanpa supervisi khusus pada aturan medis, model mampu mengekstrapolasi logika validasi state invariant untuk mencegah resep kontradiktif dengan peningkatan reliabilitas sebesar +9.0%.
-
Efisiensi Token Konteks:
Berbeda dari prompt-based critique yang memboroskan 4.000+ token per interaksi untuk re-evaluasi riwayat dari awal, model kebijakan yang dioptimasi CAST secara intrinsik menginternalisasi pemahaman aturan tanpa menambah overhead inferensi runtime.
5. Panduan Praktis Rekayasa Harness Agent Otonom
Bagi tim engineer yang sedang membangun harness autonomous agent untuk workflow misi kritis, tiga pilar utama berikut wajib diintegrasikan:
- Pisahkan Policy Execution dari Irreversible Tools: Tempatkan middleware verifikasi deterministik di depan fungsi mutasi permanen untuk memvalidasi state invariant sebelum mengeksekusi I/O ke database eksternal.
- Gunakan Trajectory Distillation dengan Rationale Sintesis: Kumpulkan log kegagalan produksi, rekonstruksi penjelasan kegagalan menggunakan verifier model, dan gunakan dataset terstruktur ini untuk continuous fine-tuning model internal.
- Ganti Metrik Evaluasi ke Pass^k: Jangan pernah menganggap agent siap produksi hanya berdasarkan skor pass@1; jalankan pengujian minimum pass^4 atau pass^8 untuk mengisolasi risiko kegagalan stokastik.
Referensi & Sumber Terverifikasi
- [1]CAST: Critique-Aware Supervision for Training Reliable Long-Horizon Tool-Calling Agents(arXiv.org (arXiv:2608.30147))
- [2]Hugging Face Daily Papers: CAST Benchmark & Rationales Discovery(Hugging Face Research Hub)
- [3]Official IEEE & ACM Computing Surveys on Autonomous Systems Safety(IEEE & ACM Computing Surveys)
Butuh Arsitektur Web & AI Berkualitas Tinggi?
Tim engineering NEWSAINT siap membantu merancang website berkecepatan tinggi, sistem AI autonomous, dan solusi SaaS terukur untuk bisnis Anda.
Artikel Terkait Lainnya

DecisionRAG (arXiv:2610.35868): Retriever-Free Retrieval via Decision Models — Eliminasi Capability Asymmetry, Hierarchical Tree Navigation, dan Rekor +17.4% Hit@1 Tanpa Indeks Vektor
Analisis arsitektur DecisionRAG (arXiv:2610.35868, Chao Wan, Paul Jünger, Beixi Du, Bodong Liu, Navaneetha Krishnan, Kilian Q. Weinberger — Cornell University & ASAPP): Mengapa retrieval konvensional (BM25, dense embeddings) menciptakan capability asymmetry terhadap LLM generator modern, dan bagaimana DecisionRAG menavigasi struktur korpus bertingkat menggunakan model keputusan (decision models) dalam konteks bersama (shared context) tanpa token generasi, menghasilkan lompatan +13.8 R@1 di MultiDoc2Dial, +17.4 Hit@1 di Natural Questions, dan latensi secepat 0.68 detik.

DynaFlow (arXiv:2610.34467): Free-Form Multi-Agent Orchestration — Sintesis Alur Kerja Eksekutabel, Eliminasi Defek Aliran Informasi, dan Lonjakan Akurasi 88.08% Tanpa Mengubah Bobot Sub-Agent
Analisis arsitektur DynaFlow (arXiv:2610.34467, Ruhao Liu et al., NUS): Mengapa topologi multi-agent statis memicu overhead komunikasi berlebihan, dan bagaimana integrasi sintesis alur kerja bebas ke dalam ruang aksi Main Agent — dikombinasikan dengan Two-Stage SFT dan kurasi 3 defek orkestrasi — menghasilkan akurasi 88.08% serta memecahkan 100% soal AIME dengan sub-agent berbobot beku.

Code Graphs & Embeddings pada Small Coding Agents (arXiv:2610.33958): Eksperimen 79k Episode SWE-bench, Gradien Hop Depth, dan Batasan Representasi Leksikal Satu-Langkah
Analisis empiris 79k episode SWE-bench Verified (arXiv:2610.33958, Saurav Bellam): Apakah tool knowledge graph dan embedding search benar-benar melengkapi pemahaman struktural coding agent kecil? Menyingkap degradasi hop gradient (odds ratio 0.50–0.67 per hop), anomali tool uptake pada model 32B, dan bukti linear probing bahwa representasi kode internal agen open-weight masih dominan bersifat leksikal satu-langkah.