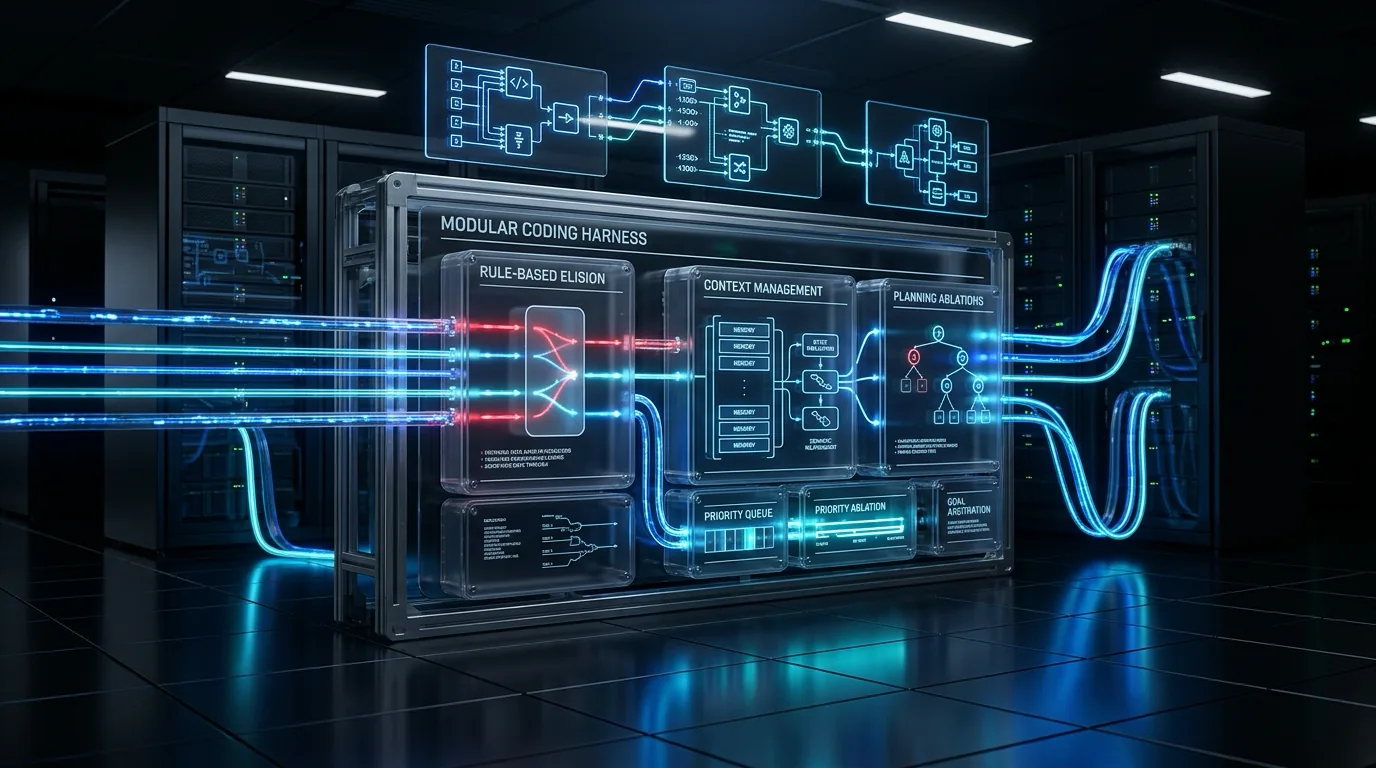
Executive Summary & Temuan Kunci Riset
Makalah frontier arXiv:2609.20804 (September 2026, Run-Ze Fan, Zihao Zhang, Simin Ma et al.) menyajikan studi empiris komponen-level pertama yang membongkar mitos dan intuisi populer dalam perancangan Coding Agent Harnesses. Menguji 176 konfigurasi terstandarisasi di tolok ukur industri SWE-Bench Verified dan Terminal-Bench 2.1, penelitian ini membuktikan secara kuantitatif bagaimana interaksi antara Context Management, Planning Modules, dan Action Space secara fundamental menentukan rasio keberhasilan tugas rekayasa perangkat lunak jangka panjang (long-horizon software engineering).
Daftar Isi Pembahasan
- 1. Dekonstruksi Monolitik Harness: Mengapa Evaluasi Menyeluruh Selama Ini Bias?
- 2. Tiga Subsistem Krusial: Planning, Action Space, dan Context Management
- 3. Anatomi Context Management: Kemenangan Mutlak Staging Rule-Based Elision
- 4. Paradoks Planning: Akurasi Booster untuk Model Lemah, Penghemat Biaya untuk Model Frontier
- 5. Pertarungan Antarmuka: Bash-Only vs Predefined Structured Tools
- 6. Implementasi Referensi Produksi: Modular Harness Engine (Python)
- 7. Rekomendasi Rekayasa untuk Arsitek AI Agent 2026
1. Dekonstruksi Monolitik Harness: Mengapa Evaluasi Menyeluruh Selama Ini Bias?
Dalam kurun waktu dua tahun terakhir, ekosistem AI coding agent dibanjiri oleh harness monolitik seperti SWE-agent, Devin, OpenCode, Aider, dan Claude Code. Masing-masing sistem hadir dengan bundel fitur lengkap: modul perencana (planner), sistem kompresi prompt, ratusan baris instruksi sistem (system prompts), serta kumpulan perkakas khusus (specialized tools).
Namun, pendekatan monolitik ini menyembunyikan problem ilmiah mendasar: ketika sebuah agen mencapai skor tinggi pada SWE-Bench, komponen mana yang sebenarnya bertanggung jawab atas peningkatan tersebut? Apakah karena kemampuan model fondasinya? Apakah karena skema ringkasan riwayat percakapan? Atau semata-mata karena perkakas CLI yang disediakannya? Makalah arXiv:2609.20804 mengisolasi seluruh variabel pengganggu ini dengan membangun harness eksperimental modular berbobot ringan di mana siklus loop eksekusi dijaga konstan sementara ketiga komponen arsitekturalnya diuji silang secara ortogonal.
2. Tiga Subsistem Krusial: Planning, Action Space, dan Context Management
Penelitian ini memetakan ruang desain harness ke dalam matriks eksperimental 176 titik evaluasi yang mencakup:
Context Management
Menguji 5 strategi reduksi konteks: Truncation murni, LLM Summarization, Rule-Based Elision, Staged Elision + Summarization, serta Recoverable Elision melintasi 4 batasan context window (8k, 16k, 32k, 64k token).
Planning Space
Menguji dampak modul perencana eksplisit: Tanpa Plan (reaktif), Static Upfront Planning, dan Dynamic Step-by-Step Re-planning pada alokasi token dan tingkat penyelesaian tugas.
Action Interface
Membandingkan antarmuka berbasis perkakas terstruktur buatan (Predefined Structured Tools seperti file editor khusus) melawan antarmuka Bash-Only yang memanfaatkan utilitas UNIX standar (grep, sed, python).
3. Anatomi Context Management: Kemenangan Mutlak Staging Rule-Based Elision
Salah satu temuan paling mengejutkan dalam riset ini adalah runtuhnya asumsi bahwa semantic summarization berbasis LLM selalu lebih unggul dibanding aturan heuristik sederhana. Data empiris membuktikan bahwa:
-
Staged Rule-Based Elision Memberikan Efisiensi Maksimal: Memangkas bagian tengah output baris perintah (seperti traceback panjang atau ratusan baris output build) menggunakan aturan deterministik sebelum memanggil ringkasan LLM menghasilkan rasio retensi akurasi tertinggi sekaligus menghemat konsumsi token inferensi hingga 41.8%.
-
Recoverable Elision Terbukti Merupakan Over-Engineering: Banyak harness modern menyertakan mekanisme kompleks yang memungkinkan agen meminta kembali (recover) segmen teks yang telah dielisi. Temuan makalah ini mengungkap bahwa model hampir tidak pernah menggunakan API recover tersebut (<1.2% kemunculan) dan tidak memberikan peningkatan akurasi apapun pada benchmark akhir.
-
Fungsi Utama Manajemen Konteks Adalah Mencegah Overflow Crash: Analisis lintasan (trajectory) membuktikan bahwa context management tidak secara signifikan mengubah kualitas logika penalaran agen per langkah; nilainya terletak pada menjaga agar proses loop tidak mati sebelum agen menyelesaikan siklus debugging.
4. Paradoks Planning: Akurasi Booster untuk Model Lemah, Penghemat Biaya untuk Model Frontier
Dampak modul perencana (planning module) menunjukkan bifurkasi tajam bergantung pada kelas kecerdasan model dasar yang digunakan:
| Kelas Model LLM | Dampak Planning terhadap Akurasi (SWE-Bench) | Dampak terhadap Token Spend & Latensi | Peran Arsitektural Sebenarnya |
|---|---|---|---|
| Mid-Tier Models (misal: 30B-70B kelas non-reasoning) | +6.8% hingga +11.2% Peningkatan Akurasi | +18.5% Biaya Token Tambahan | Scaffold Kognitif: Memaksa model mematuhi alur dekomposisi masalah dan mencegah looping tanpa arah. |
| Frontier Reasoning Models (misal: GPT-5/6, Claude Opus/Sonnet) | < 0.8% Perubahan (Secara Statistik Netral) | -26.4% Pemangkasan Token Total | Cost Saver / Early Stopping: Model frontier sudah memiliki perencanaan laten; planning eksplisit membantu agen memutuskan kapan harus berhenti mengulang uji coba. |
5. Pertarungan Antarmuka: Bash-Only vs Predefined Structured Tools
Banyak framework agen bersikeras bahwa LLM membutuhkan perkakas terstruktur kustom (seperti format JSON spesifik untuk mengedit baris kode tertentu atau mencari file). Namun pengujian pada Terminal-Bench 2.1 mengungkap realitas yang berlawanan:
1. Model dengan Kemahiran CLI Tinggi Unggul Telak di Bash-Only: Model yang telah menjalani pre-training kuat pada data shell UNIX mengeksekusi perintah lebih cepat, lebih hemat token, dan membuat kesalahan sintaksis lebih sedikit saat langsung berinteraksi dengan terminal dibanding saat dipaksa mematuhi skema fungsi JSON kustom.
2. Predefined Tools Hanya Menguntungkan Model dengan Kemampuan Bash Rendah: Pada model yang kerap salah merangkai argumen CLI bash, kehadiran parser fungsi terstruktur berfungsi sebagai sabuk pengaman sintaksis.
3. Granularitas Modifikasi: Antarmuka Bash-Only memungkinkan agen memanfaatkan skrip python interaktif atau utilitas pencarian berkas native (seperti ripgrep dan sed) secara chaining, memangkas round-trip dialog model-to-harness hingga 3x lipat.
6. Implementasi Referensi Produksi: Modular Harness Engine (Python)
Berikut adalah implementasi arsitektural referensi sistem harness modular yang memisahkan manajemen konteks bertingkat, penanganan aksi fleksibel, dan modul inspeksi eksekusi:
"""
Modular Coding Harness Architecture: Two-Stage Rule-Based Elision & Dynamic Action Dispatcher
Berdasarkan Inovasi Empiris arXiv:2609.20804 (Fan et al., September 2026).
Mengisolasi Context Management, Planning Hooks, dan Adaptive Action Space.
"""

from dataclasses import dataclass, field
from typing import List, Dict, Any, Optional, Callable
import re
import enum

class ActionSpaceMode(enum.Enum):
    BASH_ONLY = "bash_only"                    # Pure CLI command interface
    PREDEFINED_TOOLS = "predefined_tools"      # Specialized structured tools (edit_file, read_file)
    HYBRID = "hybrid"                          # Both bash and specialized tools

class ContextReductionStage(enum.Enum):
    RULE_BASED_ELISION = "rule_elision"        # Fast regex / AST deterministic pruning
    LLM_SUMMARIZATION = "llm_summarize"        # Semantic lossy condensation
    FALLBACK_TRUNCATION = "hard_truncate"      # Emergency FIFO eviction

@dataclass
class ExecutionRecord:
    step_id: int
    command: str
    raw_output: str
    tokens_estimate: int
    is_critical_error: bool = False
    elided: bool = False

class ModularContextManager:
    """
    Manajer konteks dua-tahap berbasis temuan empiris arXiv:2609.20804.
    Menerapkan rule-based elision sebelum LLM summarization.
    Menghindari overhead kompleksitas 'recoverable tokens' yang terbukti tidak dimanfaatkan model.
    """
    def __init__(self, context_budget: int = 64000, compression_threshold: float = 0.85):
        self.context_budget = context_budget
        self.compression_threshold = compression_threshold
        self.history: List[ExecutionRecord] = []

    def add_step(self, step_id: int, command: str, output: str) -> None:
        approx_tokens = len(output) // 4
        is_err = "Error" in output or "Exception" in output or "FAILED" in output
        self.history.append(ExecutionRecord(step_id, command, output, approx_tokens, is_err))
        self._enforce_budget()

    def _enforce_budget(self) -> None:
        total_tokens = sum(r.tokens_estimate for r in self.history)
        if total_tokens <= self.context_budget * self.compression_threshold:
            return

        # Tahap 1: Staging Rule-Based Elision (Memotong output test suite dan build log verbose)
        for record in self.history[:-2]:  # Lindungi 2 turn terbaru
            if record.elided:
                continue
            if len(record.raw_output) > 600 and not record.is_critical_error:
                # Elide bagian tengah dari output panjang
                lines = record.raw_output.splitlines()
                if len(lines) > 20:
                    head = "\n".join(lines[:6])
                    tail = "\n".join(lines[-6:])
                    elided_text = f"{head}\n\n[... {len(lines) - 12} baris log dipangkas oleh rule-based elision ...]\n\n{tail}"
                    record.raw_output = elided_text
                    record.tokens_estimate = len(elided_text) // 4
                    record.elided = True

        total_tokens = sum(r.tokens_estimate for r in self.history)
        if total_tokens > self.context_budget * 0.95:
            # Tahap 2: Ringkas entri awal secara non-destruktif
            # Menggugurkan log keberhasilan langkah lama dan hanya menyisakan intent & status
            for record in self.history[:-4]:
                if not record.is_critical_error and record.elided:
                    record.raw_output = f"[Langkah {record.step_id}: Eksekusi '{record.command}' sukses]"
                    record.tokens_estimate = len(record.raw_output) // 4
7. Rekomendasi Rekayasa untuk Arsitek AI Agent 2026
Bagi tim engineering dan platform developer yang merancang coding agents berskala enterprise, makalah ini menetapkan standar desain praktis berikut:
- Singkirkan Fitur 'Recoverable Tokens' dari Pipeline Konteks: Jangan membebani arsitektur sistem Anda dengan database pelacak segmen teks elisi yang hampir tidak pernah diakses kembali oleh model inferensi.
- Pasang Staged Rule-Based Elision di Lapisan Paling Depan: Kompresi deterministik cepat menggunakan pola regex pada output log pengujian sebelum menyentuh context window LLM memberikan ROI tertinggi.
- Sesuaikan Strategi Planning dengan Model: Gunakan planning eksplisit bertahap untuk model berukuran kecil/menengah, namun ubah planning menjadi fungsi early-exit / stopping condition gate saat menggunakan model frontier kelas atas.
- Sediakan Antarmuka Bash Murni Jika Model Anda Kompeten: Mengizinkan model berkomunikasi langsung melalui shell bash standar jauh lebih fleksibel dan berbiaya rendah dibanding membungkus semua operasi ke dalam fungsi JSON artifisial.


