AMV-Guard (arXiv:2610.31446): Action-Conditioned Memory Verification untuk Long-Lived LLM Agents — Mengatasi Risiko Memori Usang Melalui Sequential Stopping, Kalibrasi Risiko, dan Adaptive Value of Information (VOI)
Analisis mendalam arsitektur AMV-Guard (arXiv:2610.31446, Yiqi Wang et al.): Mengapa verifikasi memori persisten pada autonomous agent tidak boleh hanya ditentukan oleh intrinsik memori, melainkan harus dikondisikan pada konsekuensi tindakan (action consequence). Menggabungkan sequential stopping, kalibrasi empiris keandalan verifier, dan adaptive VOI dengan eliminasi 33.9% verification cost serta 0.00% gate harmful rate.
Dalam lanskap autonomous AI agents yang beroperasi lintas sesi (long-lived persistent agents), ketergantungan pada memori historis adalah pedang bermata dua. Ketika agen mengeksekusi tindakan ireversibel di dunia nyata—seperti mengeksekusi transfer perbankan, menerbitkan pesanan logistik, atau memodifikasi konfigurasi infrastruktur cloud—memori yang usang (stale memory) dapat seketika bertransformasi menjadi kerugian sistemik yang fatal.
Executive Architectural Summary
Makalah riset mutakhir dari Yiqi Wang et al. (arXiv:2610.31446), "When Is a Memory Safe Enough to Act On? Action-Conditioned Verification for Long-Lived Agents", membongkar kelemahan fatal arsitektur memori agen saat ini: keputusan apakah suatu memori harus diverifikasi ulang bukanlah properti intrinsik dari memori itu sendiri, melainkan fungsi dari konsekuensi tindakan (action consequence) yang akan dieksekusi. Melalui formulasi sequential stopping dan kalkulasi adaptive Value of Information (VOI), arsitektur AMV-Guard berhasil memangkas 33.9% biaya verifikasi dengan mempertahankan 100% safe-proceed recall dan 0.00% gate harmful rate pada ToolSandbox.
1. Ilusi Keandalan Memori: Mengapa Retrieval Saja Tidak Cukup
Sebagian besar riset memori agen LLM—mulai dari MemGPT, A-Mem, hingga mekanisme memory graph kontemporer—berfokus pada optimalisasi internal memori: meningkatkan akurasi retrieval, mendeteksi rekonsiliasi kontradiksi, atau memperbarui timestamp. Namun, pada saat agen berada di ambang eksekusi tindakan (point of action), evaluasi intrinsik memori semata terbukti runtuh. Bahkan ketika bukti pembaruan berhasil di-retrieve, model frontier terbaik hanya mencatatkan akurasi 55.2% pada benchmark memori terinvalidasi, dan agen kerap kali mengeksekusi tindakan berbahaya sebelum menyadari bahwa mereka seharusnya menolak bertindak (abstain).
Perhatikan sebuah contoh motivasional yang fundamental:
Skenario A: Pengiriman Rutin Dokumen
Agen memiliki catatan memori: "Alamat pengiriman klien adalah Jalan Merdeka No. 10", tersimpan 60 hari lalu tanpa kontradiksi dengan confidence model 0.72. Agen hendak mengirim dokumen cetak rutin berbiaya murah.
Skenario B: Pengiriman Aset Bernilai Tinggi
Dengan catatan memori yang persis identik (alamat sama, usia 60 hari, confidence 0.72), agen kali ini diminta mengeksekusi transfer kargo server enterprise bernilai miliaran rupiah ke alamat tersebut.
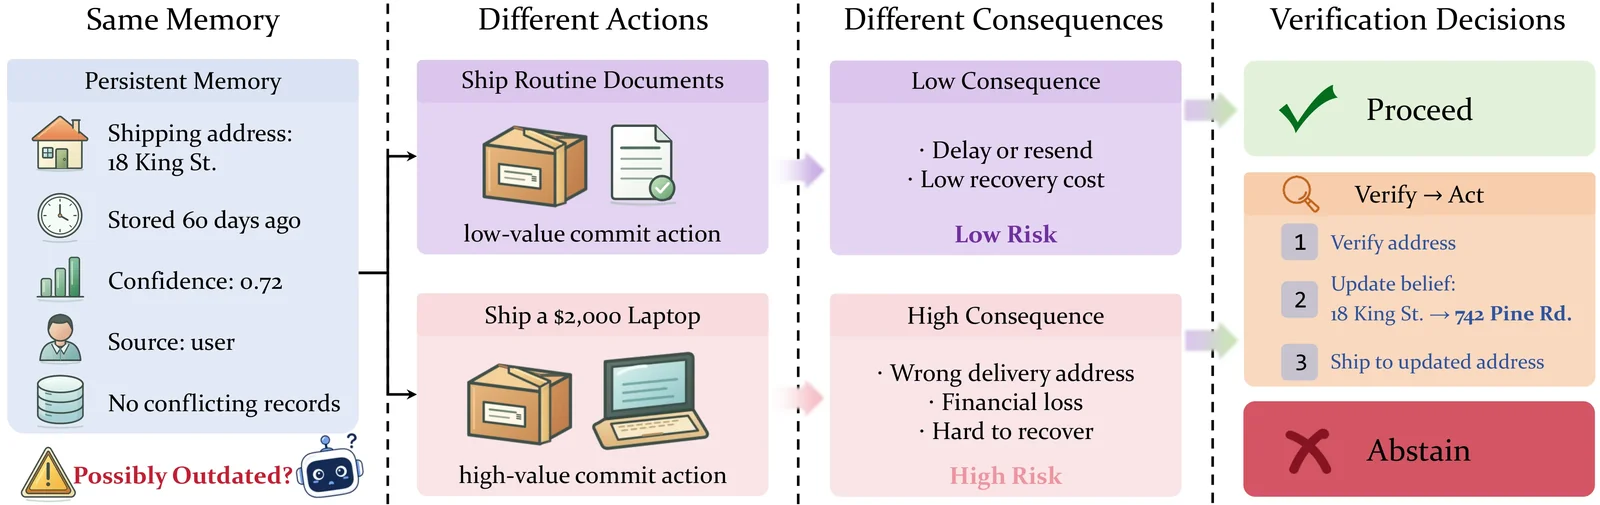 Gambar 1: Memori identik menghasilkan tiga rezim keputusan berbeda (Proceed, Verify, Abstain) murni akibat eskalasi konsekuensi tindakan θ (arXiv:2610.31446).
Eksperimen di atas membuktikan aksioma utama penelitian ini: apakah sebuah memori aman untuk dijadikan dasar tindakan bukanlah atribut dari memori itu sendiri, melainkan hasil interaksi antara tingkat kepercayaan memori, biaya verifikasi, dan besaran kerugian jika tindakan tersebut keliru.
2. Dekonstruksi Formal: Relevant vs Action-Supporting vs Critical
Salah satu kontribusi teoritis terpenting dari arXiv:2610.31446 adalah memperjelas batas konseptual yang selama ini dicampuradukkan oleh komunitas AI:
- Relevant Memory: Klaim memori yang memiliki kesamaan semantik dengan tugas yang diberikan. Ini adalah himpunan terluar yang dihasilkan oleh algoritma vector similarity retrieval atau dense retrieval.
- Action-Supporting Memory: Himpunan bagian dari memori relevan yang secara kausal menopang premis logis dari tindakan kandidat $P(a)$. Nilai parameter tool atau izin eksekusi diturunkan secara langsung dari klaim ini.
- Critical Memory: Himpunan bagian tersempit dan paling vital, di mana jika klaim memori tersebut salah di dunia nyata, kerugian eksekusi ($L(a, z)$) akan berubah secara material.
Sistem retrieval umum hanya mampu mengidentifikasi himpunan terluar (relevant). Menghabiskan kuota verifikasi untuk memverifikasi seluruh memori relevan memboroskan latensi dan biaya API secara ekstrem. Sebaliknya, arsitektur verifikasi cerdas harus membatasi verifikasi hanya pada lapisan terdalam: critical premises.
3. Proposisi Matematis 1: Tiga Rezim Keputusan Konsekuensi Tindakan
Penulis memformulasikan keputusan terminal agen sebagai ruang biner $mathcal{D}(a) = { ext{PROCEED}(a), ext{ABSTAIN}}$, dengan kerugian $L(d, z)$. Misalkan probabilitas bahwa premis memori salah adalah $p in (0, 1)$, biaya abstain adalah $kappa > 0$, dan biaya verifikasi adalah $c ge 0$ dengan keandalan simetris verifier $r in (0.5, 1.0]$. Jika eksekusi di bawah premis yang salah menimbulkan kerugian $ heta > 0$, maka probabilitas a posteriori setelah observasi konfirmasi ($p^+$) dan refutasi ($p^-$) adalah:
p^- = [p r] / [(1 - p)(1 - r) + p r]
Dari formulasi ini lahirlah Proposisi 1 (Consequence Induces Three Regimes): terdapat ambang batas teratur $ heta_1 le heta_2$ sedemikian rupa sehingga:
- Jika konsekuensi tindakan rendah ($ heta < heta_1$), keputusan optimal adalah langsung PROCEED tanpa membuang biaya verifikasi.
- Jika konsekuensi tindakan berada pada zona menengah ($ heta_1 le heta < heta_2$), keputusan optimal adalah menjalankan query VERIFY.
- Jika konsekuensi tindakan melampaui ambang batas kritis ($ heta ge heta_2$), keputusan optimal adalah langsung ABSTAIN.
Wawasan yang sangat mendalam di balik poin ketiga: pada verifier yang tidak sempurna ($r < 1$), terdapat tingkat bahaya di mana bahkan jika verifier memberikan konfirmasi positif, posterior error $p^+$ masih terlalu tinggi untuk menjustifikasi risiko eksekusi. Oleh karena itu, tindakan paling rasional bagi agen berisiko tinggi adalah menolak mengeksekusi secara langsung tanpa membuang biaya verifikasi!
4. Jebakan Naive Value of Information (Remark 1)
Pendekatan intuitif yang kerap diadopsi insinyur adalah mengukur nilai verifikasi berdasarkan seberapa besar ia mereduksi risiko ekspektasian tindakan kandidat:
Para peneliti membuktikan secara matematis dalam Remark 1 bahwa formulasi naif ini bersifat degeneratif (rusak secara fundamental). Mengapa? Karena berdasarkan hukum probabilitas total dan sifat martingal dari ekspektasi Bayesian:
Akibatnya, $ ext{VOI}_{ ext{naive}}(q) equiv -lambda C(q) le 0$ selalu bernilai negatif! Jika agen menggunakan rumus ini dengan aturan "verifikasi jika VOI > 0", agen tidak akan pernah menjalankan verifikasi apa pun.
Informasi baru tidak memiliki nilai ekonomi intrinsik terhadap tindakan yang statis; informasi hanya berharga jika ia memiliki kapasitas untuk mengubah keputusan terminal agen (misalnya dari PROCEED menjadi ABSTAIN atau REPLAN). Oleh karena itu, AMV-Guard menggantikan risiko tindakan statis dengan screened stopping value $V_{ ext{stop}}(b, a)$:
5. Arsitektur Runtime AMV-Guard
AMV-Guard beroperasi sebagai verification gate transparan yang menyaring setiap tindakan eksternal (commit action) sebelum dieksekusi ke lingkungan fisik.
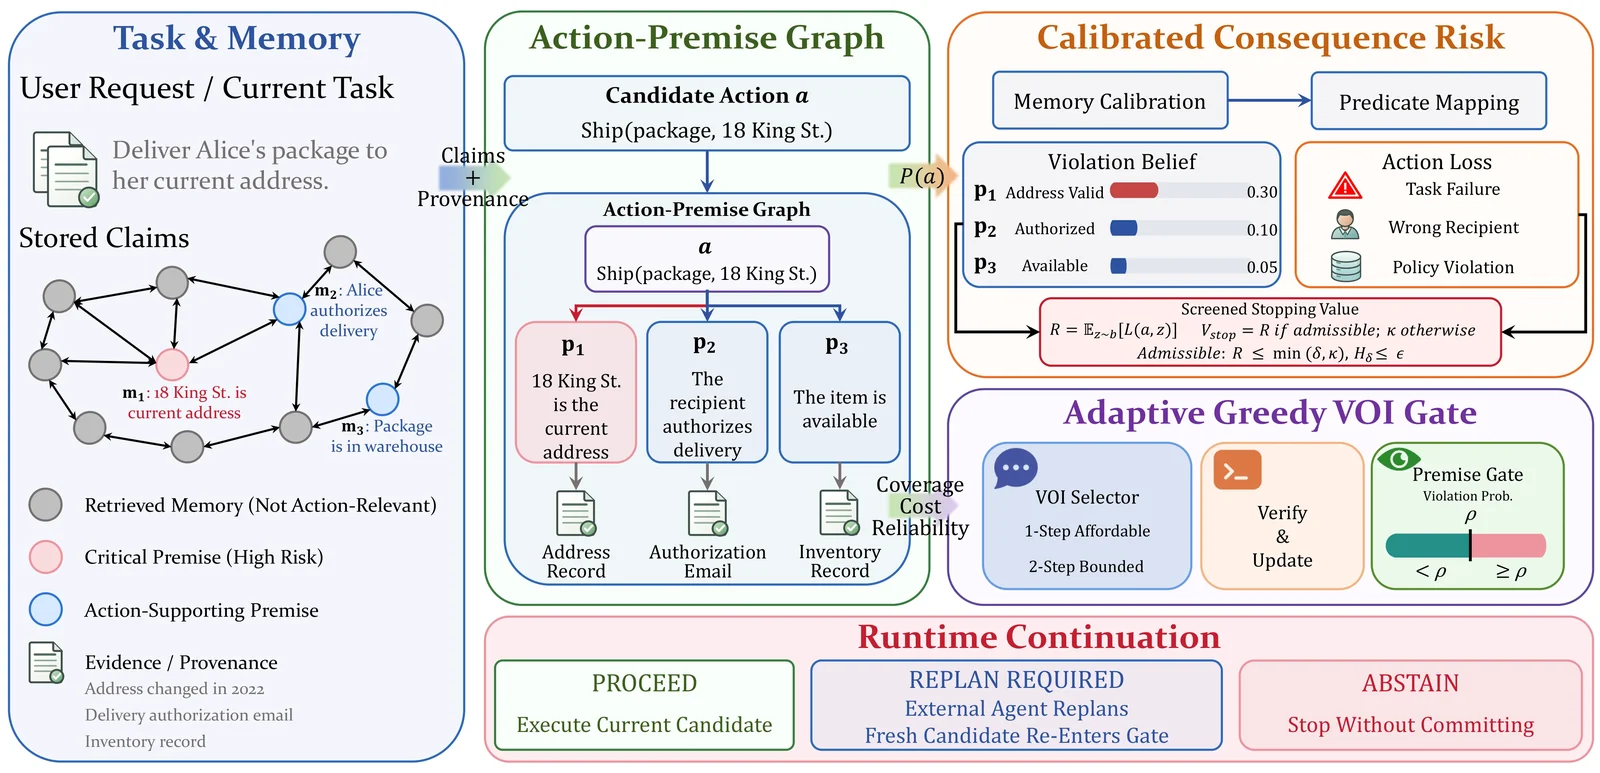 Gambar 2: Pipeline arsitektur AMV-Guard. Dari ekstraksi premis hingga sequential Bayesian stopping dan adaptive two-step lookahead (arXiv:2610.31446).
Pipeline ini terdiri dari tiga modul utama yang bekerja secara orkestratif:
1. Dual-Layer Premise Extractor
Mengisolasi premis pendukung tindakan kandidat menggunakan dua layer independen: layer LLM (yang memetakan argumen tool ke ID memori spesifik) dan layer aturan publik (tool contract layer yang mendeteksi prasyarat skema API). Filter counterfactual memangkas pasangan tool-target yang terbukti tidak relevan pada data pelatihan.
2. Calibrated Consequence-Aware Risk Engine
Confidence bawaan model LLM terkenal mengalami overconfidence yang parah saat menghadapi halusinasi. AMV-Guard mengalibrasi probabilitas kegagalan $p_i$ menggunakan model logistik terkalibrasi Platt/Beta berbasis vektor fitur: usia memori (recency decay), indeks kepercayaan sumber, deteksi kontradiksi di memory graph, dan sinyal internal model.
3. Adaptive Greedy Verification dengan Two-Step Fallback
Menghitung skor VOI untuk setiap query verifier yang terjangkau budget. Jika verifikasi komplementer dibutuhkan (di mana satu query tidak cukup mengubah keputusan tetapi sepasang query mampu mengubahnya), modul mengaktifkan two-step lookahead ($ ext{VOI}_2$). Jika bukti menunjukkan premis terlanggar melampaui batas $
ho$, gate memicu sinyal ReplanRequired ke agent loop.
6. Evaluasi Empiris: ToolSandbox dan AppWorld
Untuk membuktikan performa arsitektur ini di dunia nyata, para peneliti mengujinya pada dua lingkungan eksekusi stateful standar industri: ToolSandbox (3.520 instance beku dengan 10 famili perturbasi memori tersembunyi) dan AppWorld (100 tugas mutasi state kompleks lintas aplikasi email, perbankan, dan e-commerce).
| Metode Evaluasi | Safe Recall ↑ | Gate Harmful ↓ | Verify Cost ↓ | Task Success ↑ | Coverage ↑ |
|---|---|---|---|---|---|
| Always Proceed | 100.00% | 66.67% | 0.000 | 68.23% | 100.00% |
| Always Verify All | 100.00% | 23.67% | 1.976 | 74.58% | 62.67% |
| EnvProbe-Simple | 100.00% | 49.00% | 2.018 | 74.48% | 87.00% |
| CTA (Cost-Aware) | 99.83% | 63.61% | 0.123 | 67.71% | 96.89% |
| AMV-Static | 100.00% | 0.00% | 1.843 | 72.34% | 38.83% |
| AMV-Guard (Ours) | 100.00% | 0.00% | 1.219 | 73.91% | 44.17% |
Tabel 1: Hasil pengujian live end-to-end pada ToolSandbox (3 observation seeds × 640 test instances). AMV-Guard menurunkan biaya verifikasi 33.9% vs AMV-Static tanpa kebocoran aksi berbahaya (Gate harmful 0.00%).
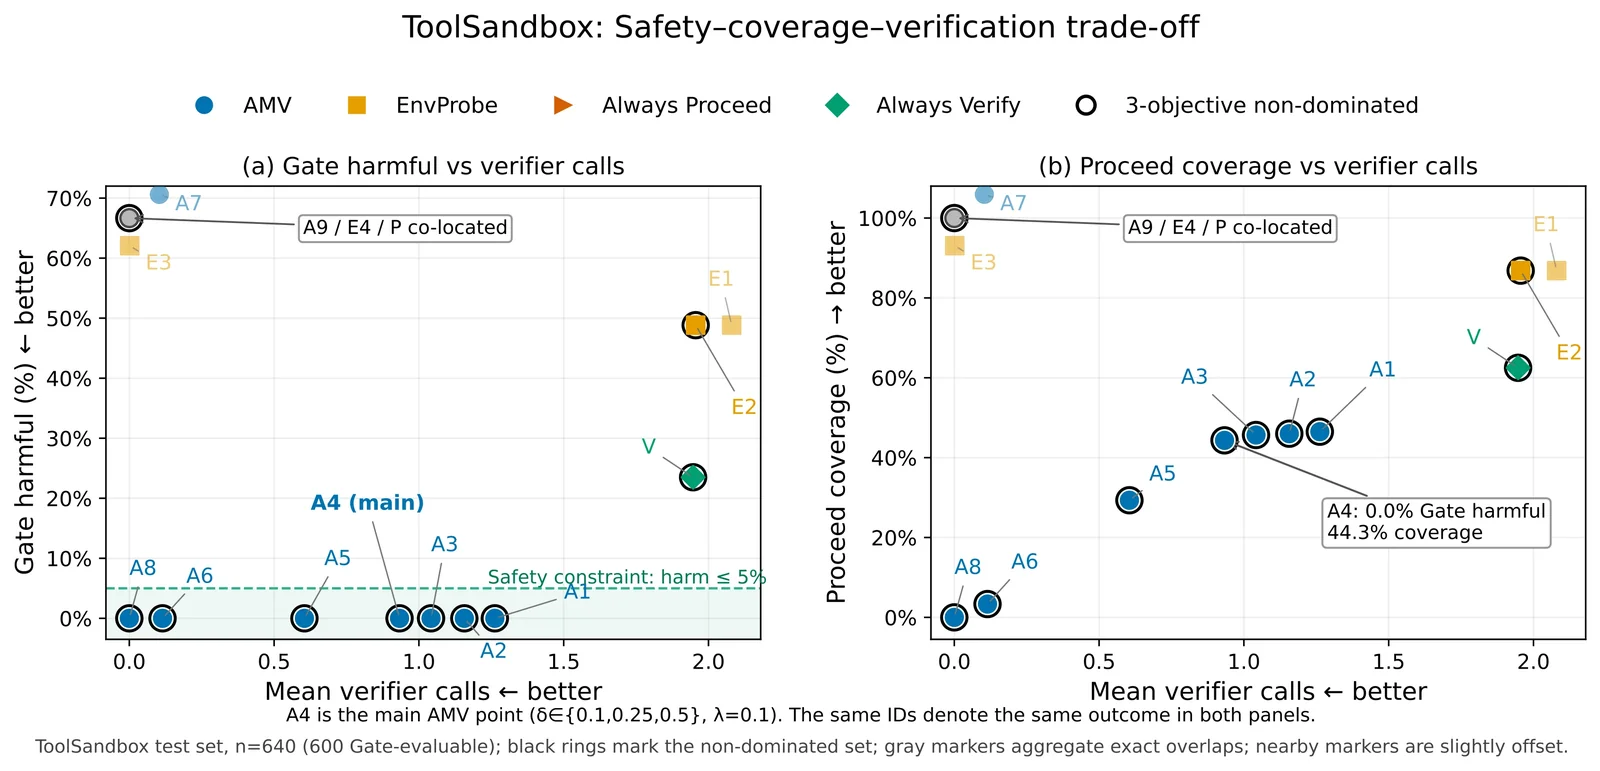 Gambar 3: Pareto Frontier tingkat bahaya versus pemanggilan verifikasi (arXiv:2610.31446).
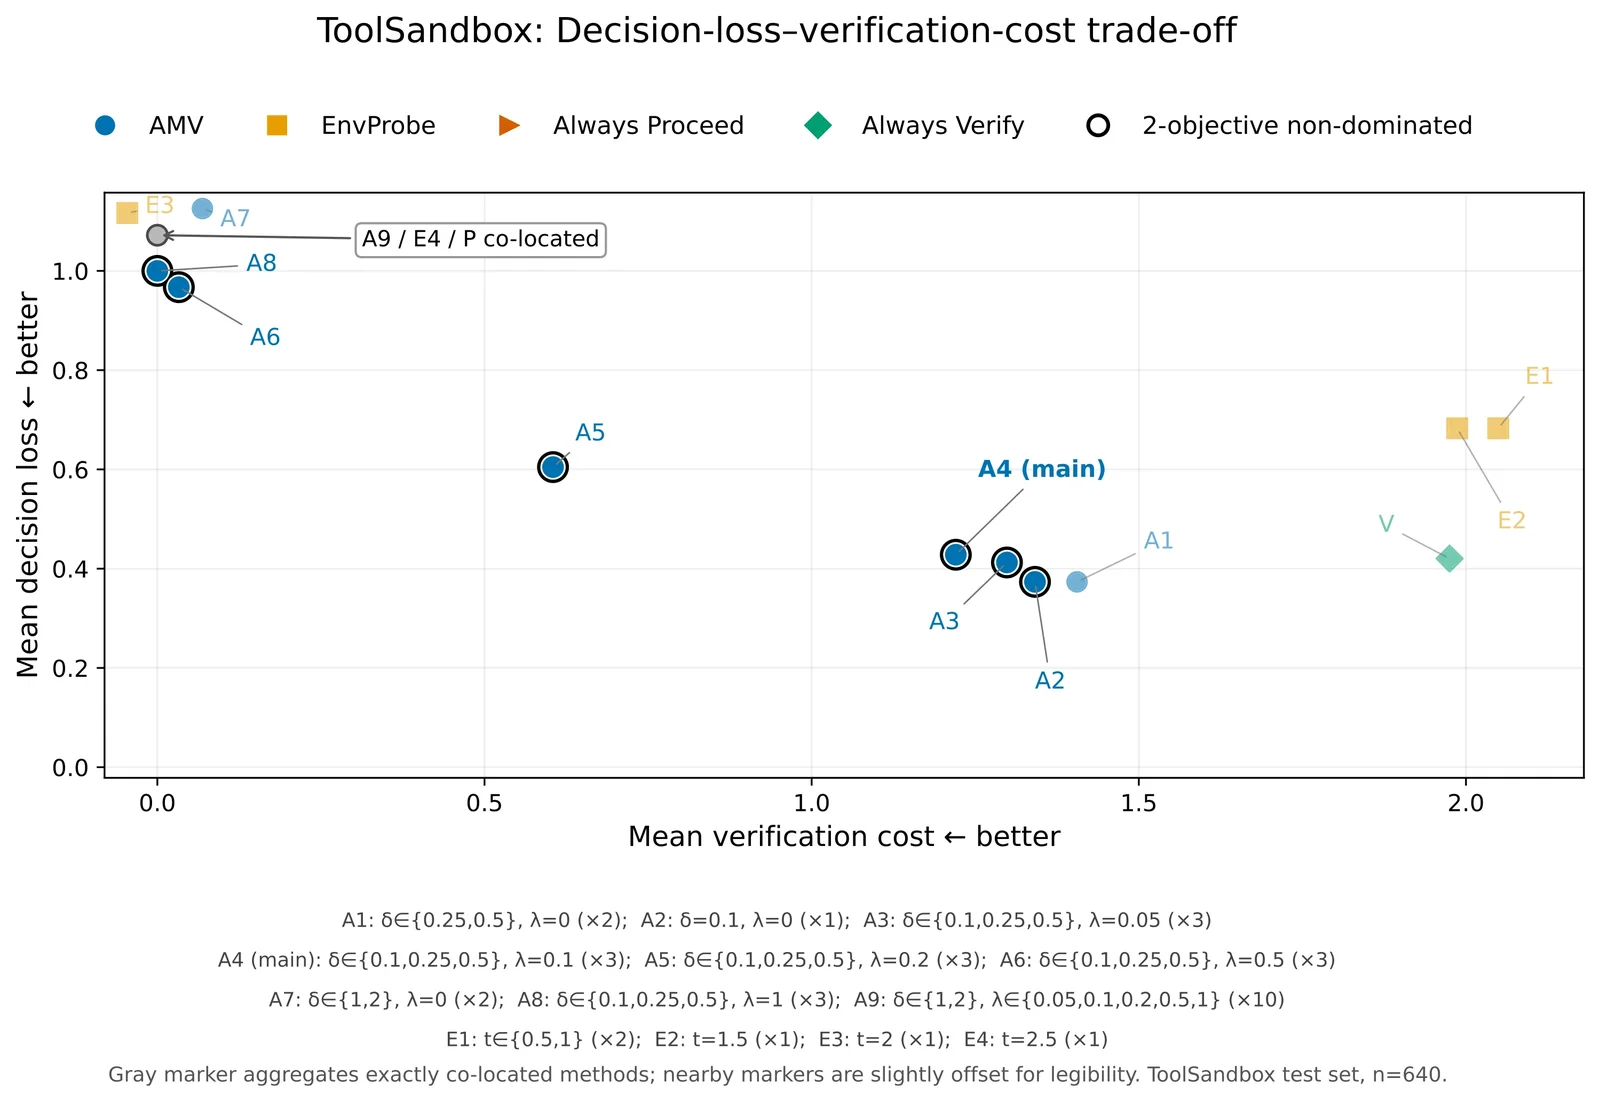 Gambar 4: Pareto Frontier loss total vs biaya komputasi verifikasi (arXiv:2610.31446).
7. Temuan Riset dan Analisis Performa Kritis
Pengujian ekstensif lintas backbone model (Qwen3.5-35B-A3B, Qwen3.5-27B, dan DeepSeek-V4.1-Flash) mengungkapkan sejumlah temuan kunci bagi rekayasa sistem agen masa depan:
- Eliminasi Absolut Gate Harmful: Dibandingkan dengan Always Proceed (yang memicu 66.67% tindakan berbahaya) dan Always Verify (23.67% tindakan berbahaya karena verifier berisik), AMV-Guard secara deterministik mengunci 0.00% Gate Harmful. Sistem tidak pernah mengeksekusi aksi di mana premis yang diperlukan berada dalam kondisi invalid.
- Efisiensi Biaya Verifikasi 33.9%: Menggantikan kebijakan statis dengan dynamic adaptive VOI memangkas biaya pemanggilan query dari 1.843 menjadi 1.219 (penurunan 33.9%), sekaligus meningkatkan Proceed Coverage dari 38.83% menjadi 44.17%. Hal ini membuktikan bahwa verifikasi adaptif membebaskan agen untuk bertindak ketika risiko rendah, alih-alih paranoid memverifikasi segalanya.
- Ketahanan Generalisasi Out-of-Domain (AppWorld Transfer): Pada transfer zero-shot ke benchmark AppWorld tanpa fine-tuning arsitektur, modul inti AMV-Guard berhasil menurunkan biaya verifikasi sebesar 21.3% (dari 2.655 ke 2.090) dengan mempertahankan tingkat Gate Harmful terendah di angka 7.89% (dibandingkan Always Proceed sebesar 18.95% dan EnvProbe 17.37%).
8. Implementasi Kode Produksi: Runtime Engine AMV-Guard
Berikut adalah implementasi referensi TypeScript produksi dari modul inferensi sequential stopping, kalibrasi logistik Platt/Beta, dan kalkulasi one-step VOI:
// Production Implementation: AMV-Guard Runtime Engine
// Implements Proposition 1 Regimes, Calibrated Risk, and Adaptive One-Step VOI

export type ActionRegime = 'PROCEED' | 'VERIFY' | 'ABSTAIN';

export interface MemoryClaim {
  id: string;
  statement: string;
  timestamp: number;
  sourceTrustScore: number; // [0, 1]
  modelConfidence: number; // Raw model logit / probe confidence [0, 1]
  recencyHours: number;
  contradictionFlag: boolean;
}

export interface Premise {
  id: string;
  claimId: string;
  dependencyType: 'direct' | 'transitive' | 'joint';
  parameterTarget: string;
  calibratedViolationProbability: number; // p_i in [0, 1]
}

export interface CandidateAction {
  actionId: string;
  toolName: string;
  arguments: Record;
  impactCostTheta: number; // \theta: Biaya malapetaka eksekusi di bawah premis salah
  abstentionCostKappa: number; // \kappa: Penalti penolakan bertindak
  premises: Premise[];
}

export interface Verifier {
  id: string;
  resolvesPremiseIds: string[];
  executionCost: number; // c >= 0
  symmetricReliability: number; // r in (0.5, 1.0]
}

export class AMVGuardEngine {
  constructor(
    private lambdaCostScale = 1.0,
    private deltaLossThreshold = 10.0,
    private epsilonHarmBound = 0.05
  ) {}

  public calibratePremiseFailureProbability(claim: MemoryClaim): number {
    const recencyPenalty = Math.min(1.0, claim.recencyHours / (24 * 30));
    const logitConf = Math.log(Math.max(1e-5, claim.modelConfidence) / Math.max(1e-5, 1 - claim.modelConfidence));
    const z = -0.85 - (1.42 * logitConf) + (2.15 * recencyPenalty) - (1.80 * claim.sourceTrustScore) + (claim.contradictionFlag ? 2.5 : 0.0);
    return Math.max(0.001, Math.min(0.999, 1.0 / (1.0 + Math.exp(-z))));
  }

  public computeStoppingValue(candidate: CandidateAction): { vStop: number; rExpected: number; hHarm: number } {
    let pAnyViolation = 0.0;
    for (const p of candidate.premises) {
      pAnyViolation = 1.0 - (1.0 - pAnyViolation) * (1.0 - p.calibratedViolationProbability);
    }
    const rExpected = pAnyViolation * candidate.impactCostTheta;
    const hHarm = pAnyViolation;
    const isAdmissible = rExpected <= Math.min(this.deltaLossThreshold, candidate.abstentionCostKappa) &&
                         hHarm <= this.epsilonHarmBound;
    return { vStop: isAdmissible ? rExpected : candidate.abstentionCostKappa, rExpected, hHarm };
  }

  public computeOneStepVOI(candidate: CandidateAction, verifier: Verifier, currentVStop: number): number {
    const targetPremise = candidate.premises.find(p => verifier.resolvesPremiseIds.includes(p.id));
    if (!targetPremise) return -this.lambdaCostScale * verifier.executionCost;

    const p = targetPremise.calibratedViolationProbability;
    const r = verifier.symmetricReliability;
    const pConfirm = (1.0 - p) * r + p * (1.0 - r);
    const pRefute = 1.0 - pConfirm;

    const pPlus = (p * (1.0 - r)) / pConfirm;
    const pMinus = (p * r) / pRefute;

    const vStopConfirm = this.computeStoppingValue({
      ...candidate,
      premises: candidate.premises.map(pm => pm.id === targetPremise.id ? { ...pm, calibratedViolationProbability: pPlus } : pm)
    }).vStop;

    const vStopRefute = this.computeStoppingValue({
      ...candidate,
      premises: candidate.premises.map(pm => pm.id === targetPremise.id ? { ...pm, calibratedViolationProbability: pMinus } : pm)
    }).vStop;

    const grossVOI = currentVStop - (pConfirm * vStopConfirm + pRefute * vStopRefute);
    return grossVOI - (this.lambdaCostScale * verifier.executionCost);
  }

  public evaluate(candidate: CandidateAction, verifiers: Verifier[]): { regime: ActionRegime; selectedVerifier?: Verifier } {
    const { vStop, rExpected, hHarm } = this.computeStoppingValue(candidate);
    let bestV: Verifier | undefined;
    let maxVOI = -Infinity;

    for (const v of verifiers) {
      const voi = this.computeOneStepVOI(candidate, v, vStop);
      if (voi > maxVOI) {
        maxVOI = voi;
        bestV = v;
      }
    }

    if (maxVOI > 0 && bestV) return { regime: 'VERIFY', selectedVerifier: bestV };
    if (rExpected <= Math.min(this.deltaLossThreshold, candidate.abstentionCostKappa) && hHarm <= this.epsilonHarmBound) {
      return { regime: 'PROCEED' };
    }
    return { regime: 'ABSTAIN' };
  }
}
9. Kesimpulan Arsitektural untuk Rekayasa AI Agent
Riset AMV-Guard menandai perubahan paradigma mendasar dalam desain sistem agen otonom. Masa di mana sistem agen memperlakukan memori sebagai repositori pasif telah berakhir. Dalam sistem otonom kelas enterprise:
- Memori Tidak Boleh Dipercaya Secara Membabi Buta: Tingkat kepercayaan memori historis harus dikalibrasi secara berkala terhadap keusangan waktu dan riwayat sumber.
- Kondisikan Verifikasi pada Konsekuensi: Verifikasi adalah keputusan ekonomi. Nilai verifikasi dihitung bukan dari seberapa penasaran sistem terhadap memori, melainkan apakah hasil observasi dapat menyelamatkan sistem dari keputusan fatal.
- Sediakan Opsi Abstain Eksplisit: Agen yang aman harus memiliki kemampuan untuk menolak bertindak ketika ketidakpastian tinggi dan verifikasi tidak mampu menjamin keselamatan. Menolak bertindak secara terencana jauh lebih berharga daripada kegagalan katastropik di lingkungan produksi.
Referensi & Sumber Terverifikasi
- [1]When Is a Memory Safe Enough to Act On? Action-Conditioned Verification for Long-Lived Agents(arXiv.org / AI & Autonomous Systems (arXiv:2610.31446))
- [2]ToolSandbox: A State-Grounded Benchmark for Evaluating LLM Agents in Interactive Environments(UC Berkeley & Center for Human-Compatible AI)
- [3]AppWorld: A Controllable World of Apps and People for Benchmarking Interactive Coding Agents(Stony Brook University & Allen Institute for AI (AI2))
Butuh Arsitektur Web & AI Berkualitas Tinggi?
Tim engineering NEWSAINT siap membantu merancang website berkecepatan tinggi, sistem AI autonomous, dan solusi SaaS terukur untuk bisnis Anda.
Artikel Terkait Lainnya

DecisionRAG (arXiv:2610.35868): Retriever-Free Retrieval via Decision Models — Eliminasi Capability Asymmetry, Hierarchical Tree Navigation, dan Rekor +17.4% Hit@1 Tanpa Indeks Vektor
Analisis arsitektur DecisionRAG (arXiv:2610.35868, Chao Wan, Paul Jünger, Beixi Du, Bodong Liu, Navaneetha Krishnan, Kilian Q. Weinberger — Cornell University & ASAPP): Mengapa retrieval konvensional (BM25, dense embeddings) menciptakan capability asymmetry terhadap LLM generator modern, dan bagaimana DecisionRAG menavigasi struktur korpus bertingkat menggunakan model keputusan (decision models) dalam konteks bersama (shared context) tanpa token generasi, menghasilkan lompatan +13.8 R@1 di MultiDoc2Dial, +17.4 Hit@1 di Natural Questions, dan latensi secepat 0.68 detik.

DynaFlow (arXiv:2610.34467): Free-Form Multi-Agent Orchestration — Sintesis Alur Kerja Eksekutabel, Eliminasi Defek Aliran Informasi, dan Lonjakan Akurasi 88.08% Tanpa Mengubah Bobot Sub-Agent
Analisis arsitektur DynaFlow (arXiv:2610.34467, Ruhao Liu et al., NUS): Mengapa topologi multi-agent statis memicu overhead komunikasi berlebihan, dan bagaimana integrasi sintesis alur kerja bebas ke dalam ruang aksi Main Agent — dikombinasikan dengan Two-Stage SFT dan kurasi 3 defek orkestrasi — menghasilkan akurasi 88.08% serta memecahkan 100% soal AIME dengan sub-agent berbobot beku.

Code Graphs & Embeddings pada Small Coding Agents (arXiv:2610.33958): Eksperimen 79k Episode SWE-bench, Gradien Hop Depth, dan Batasan Representasi Leksikal Satu-Langkah
Analisis empiris 79k episode SWE-bench Verified (arXiv:2610.33958, Saurav Bellam): Apakah tool knowledge graph dan embedding search benar-benar melengkapi pemahaman struktural coding agent kecil? Menyingkap degradasi hop gradient (odds ratio 0.50–0.67 per hop), anomali tool uptake pada model 32B, dan bukti linear probing bahwa representasi kode internal agen open-weight masih dominan bersifat leksikal satu-langkah.