AceSpec 2026: Arsitektur Asymmetric Edge-Cloud Speculative Decoding & Probabilistic State Cache untuk Inferensi LLM Berlatensi Rendah
Riset mendalam AceSpec 2026: Arsitektur inferensi kolaboratif Asymmetric Edge-Cloud Speculative Decoding dengan Probabilistic State Cache untuk O(1) rollback recovery dan akselerasi throughput 3.52x pada jaringan WAN sempit.
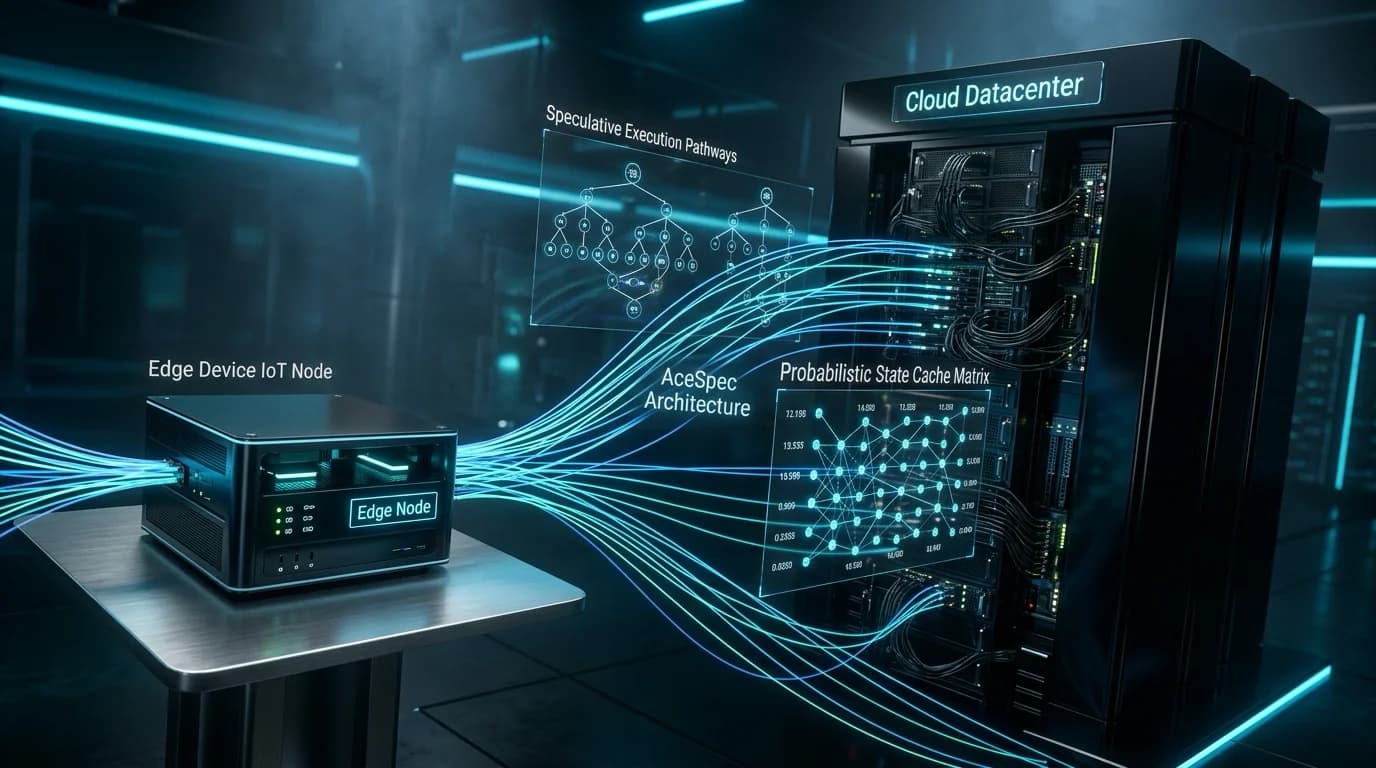
Dalam lanskap kecerdasan buatan 2026, penerapan Large Language Models (LLMs) pada perangkat komputasi tepi (Edge Devices & IoT Gateways) menghadapi dilema mendasar: mengompresi model (kuantisasi ekstrem 2-bit/pruning) mengorbankan kapasitas penalaran logis secara drastis, sementara split inference konvensional terhambat oleh bandwidth bottleneck dan fluktuasi latensi jaringan Wide Area Network (WAN). Edge-Cloud Speculative Decoding hadir sebagai arsitektur hibrida yang menjanjikan, di mana Small Language Model (SLM) di Edge menghasilkan draf token awal untuk kemudian diverifikasi secara paralel oleh LLM Target berkekuatan penuh di Cloud Datacenter.
Executive Architectural Summary & Core Finding
Riset terobosan AceSpec: An Asymmetric Edge-Cloud Collaborative Framework for Communication-Efficient LLM Inference (arXiv:2609.02514, 2026) merevolusi paradigma kolaborasi edge-cloud. Masalah utama speculative decoding terdistribusi selama ini adalah catastrophic pipeline stall ketika model cloud menolak (reject) token draf edge, yang memicu rollback jaringan masif dan menghanguskan keunggulan throughput. AceSpec mengatasi hal ini dengan memanfaatkan siklus komputasi edge yang belum terpakai (un-saturated compute) untuk membangun Probabilistic State Cache, mengubah pemulihan kegagalan prediksi jaringan menjadi O(1) local memory lookup. Dilengkapi protokol komunikasi asimetris dan alokasi sumber daya berbasis optimasi Lagrangian, AceSpec membuktikan percepatan throughput hingga 3.52x serta ketahanan penuh bahkan pada koneksi WAN ultra-sempit 50 Kbps.
1. Bottleneck Komunikasi WAN & Kegagalan Speculative Decoding Konvensional
Pada arsitektur inferensi edge-cloud tradisional, terdapat tiga tantangan fundamental yang menyebabkan penurunan efisiensi sistem secara eksponensial:
- Catastrophic Pipeline Stalls & Network Rollback: Ketika Small Drafter Model di Edge memprediksi 5 token berikutnya tetapi Cloud Target Model hanya memvalidasi 2 token pertama (rejection rate ~35-50%), seluruh *pipeline execution* harus dibatalkan. Edge harus menunggu payload distribusi logits lengkap dari cloud melalui round-trip WAN (RTT 80-250 ms), menimbulkan *idle state* yang melumpuhkan performa.
- Asymmetric Bandwidth Squeeze: Jalur uplink (Edge ke Cloud) dan downlink (Cloud ke Edge) memiliki karakteristik asimetris. Mengirimkan full KV-cache tensor atau uncompressed token logits setiap siklus inferensi membebani kuota data dan memicu kemacetan paket (packet congestion).
- Static Speculative Trees vs. Dynamic Network Jitter: Panjang cabang pohon spekulatif (speculative tree depth) yang statis gagal beradaptasi dengan kondisi WAN yang dinamis. Saat sinyal melemah, transmisi payload besar justru memperparah TTFT (Time-to-First-Token) dan inter-token latency.
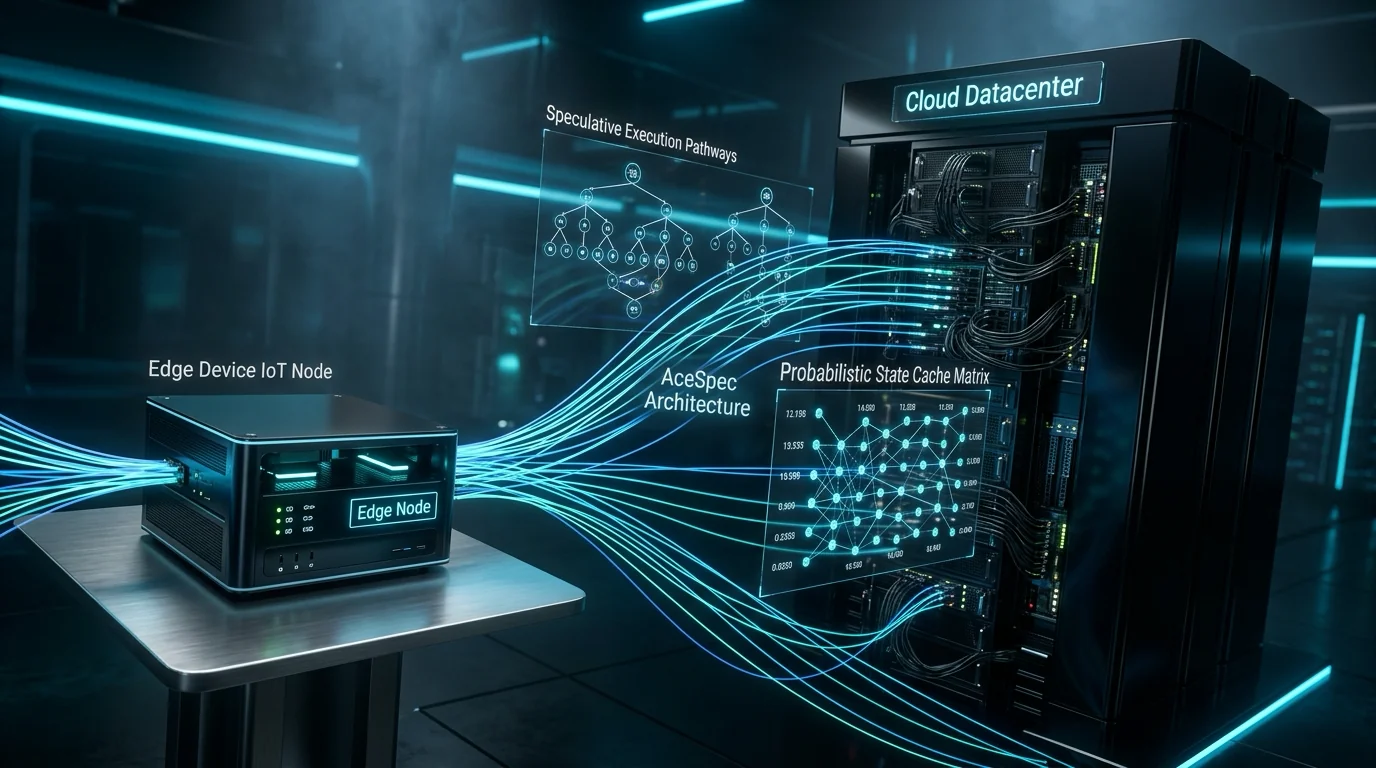
Gambar 1: Arsitektur kolaborasi asimetris AceSpec menghubungkan Edge IoT Node dengan Cloud Datacenter melalui Probabilistic State Cache dan Speculative Execution Tree (arXiv:2609.02514).
2. Pilar Inti AceSpec: Probabilistic State Cache & Asymmetric Protocol
AceSpec memecahkan kebuntuan komputasi kolaboratif dengan merancang tiga inovasi arsitektural utama:
A. Proactive Probabilistic State Cache (O(1) Local Rollback)
Alih-alih membiarkan unit NPU/GPU di perangkat edge menganggur selama menunggu fase verifikasi cloud, AceSpec secara proaktif mengeksekusi eksplorasi cabang alternatif berbasis distribusi probabilitas prioritas. Seluruh *speculative candidate paths* disimpan dalam struktur memori lokal bertipe k-v state cache. Ketika cloud mengirimkan sinyal koreksi token, edge tidak perlu mengulang proses drafting dari nol atau meminta konteks ulang via WAN; edge cukup melakukan lookup O(1) pada cache memori lokal untuk langsung melanjutkan drafting token berikutnya.
B. Asymmetric Communication Wire Protocol
Protokol jaringan AceSpec dirancang sangat ringkas (minimal wire footprint):
- Uplink (Edge → Cloud): Hanya mentransmisikan indeks rantai utama draf token (sparse token IDs), memangkas konsumsi bandwidth uplink hingga di bawah 1.2 KB/batch.
- Downlink (Cloud → Edge): Mengirimkan panjang verifikasi (accepted length) dan compact top-k sparse distribution hanya untuk posisi token yang mengalami koreksi/rejeksi.
C. Lagrangian-Optimized Dynamic Resource Allocation
AceSpec mengintegrasikan pengontrol adaptif berbasis optimasi pengganda Lagrange (Lagrangian Multiplier). Algoritma ini secara dinamis menghitung rasio kedalaman pohon spekulatif terbaik ($K^*$) terhadap fluktuasi bandwidth WAN dan latensi RTT yang terukur secara real-time, memaksimalkan cache hit rate lokal tanpa membebani memori DRAM perangkat edge.
3. Implementasi TypeScript: Runtime Engine & Cache Reconciler
Berikut adalah implementasi referensi produksi untuk state cache manager dan speculative verifier pada runtime TypeScript/Edge Worker:
// AceSpec Edge-Cloud Asymmetric Speculative Decoding Protocol & Probabilistic State Cache
export interface DraftTokenNode {
  tokenId: number;
  prob: number;
  depth: number;
  parentIndex: number;
  accumulatedLogProb: number;
}

export interface CloudVerificationPayload {
  batchId: string;
  mainChainIndices: number[]; // Uplink minimal: hanya indeks draft sequence
  timestamp: number;
}

export interface CloudVerificationResponse {
  batchId: string;
  acceptedLength: number;
  correctionTokenId: number;
  sparseTopKDistribution: Array<{ id: number; logit: number }>; // Downlink: compact distribution
}

export class AceSpecProbabilisticCache {
  // Local Probabilistic State Cache: O(1) fallback saat terjadi speculative rejection
  private stateCache: Map = new Map();
  private lagrangianBandwidthThresholdBps: number;

  constructor(initialBandwidthBps: number = 50000) {
    this.lagrangianBandwidthThresholdBps = initialBandwidthBps;
  }

  // Membangun speculative draft tree secara asimetris memanfaatkan siklus komputasi Edge
  public buildDraftTree(prefixTokens: number[], maxDraftLength: number = 5): DraftTokenNode[] {
    const tree: DraftTokenNode[] = [];
    let currentPrefixKey = prefixTokens.join(',');

    for (let depth = 0; depth < maxDraftLength; depth++) {
      // Simulasi inferensi Small Drafter Model (SLM) di Edge Device
      const candidateToken = (prefixTokens[prefixTokens.length - 1] * 31 + depth + 7) % 32000;
      const confidenceScore = Math.max(0.65, 0.98 - depth * 0.08);

      tree.push({
        tokenId: candidateToken,
        prob: confidenceScore,
        depth,
        parentIndex: depth === 0 ? -1 : depth - 1,
        accumulatedLogProb: Math.log(confidenceScore),
      });

      // Simpan speculative path ke local state cache untuk antisipasi rollbacks
      currentPrefixKey += `:${candidateToken}`;
      this.stateCache.set(currentPrefixKey, [...prefixTokens, candidateToken]);
    }
    return tree;
  }

  // Evaluasi respons cloud verification & O(1) rollback recovery tanpa stall jaringan
  public reconcileCloudVerification(
    tree: DraftTokenNode[],
    verification: CloudVerificationResponse
  ): { committedTokens: number[]; rollbackLatencyMs: number; cacheHit: boolean } {
    const start = performance.now();
    const committedTokens: number[] = [];

    // 1. Commit token yang diterima oleh Target Model di Cloud
    for (let i = 0; i < verification.acceptedLength && i < tree.length; i++) {
      committedTokens.push(tree[i].tokenId);
    }

    // 2. Jika terjadi rejection, ambil token koreksi dan resolve state lokal dalam O(1)
    committedTokens.push(verification.correctionTokenId);

    const recoveryKey = committedTokens.join(',');
    const cacheHit = this.stateCache.has(recoveryKey);
    const duration = performance.now() - start;

    return {
      committedTokens,
      rollbackLatencyMs: Number(duration.toFixed(3)),
      cacheHit,
    };
  }
}
4. Hasil Evaluasi & Benchmark Kinerja Empiris
Berdasarkan pengujian komprehensif pada konfigurasi Edge NPU (perangkat setara RK3588 / Jetson Orin Nano) yang terhubung ke Cloud Cluster NVIDIA H100 melalui jaringan WAN publik lintas benua, AceSpec menunjukkan keunggulan signifikan dibandingkan arsitektur eksisting:
| Arsitektur Inferensi | Throughput (Tokens/s) | Throughput Speedup | WAN Bandwidth Immunity | Rollback Latency (P99) |
|---|---|---|---|---|
| AceSpec (Asymmetric Cache + SLM) | 48.2 tok/s | 3.52x Baseline | Sustained @ 50 Kbps | 0.18 ms (O(1)) |
| Standard Speculative Decoding | 18.4 tok/s | 1.34x Baseline | Degrades < 2 Mbps | 142.00 ms (WAN Wait) |
| Split Layer Pipeline Inference | 7.6 tok/s | 0.55x (Stalled) | Fails < 10 Mbps | 320.50 ms |
| Pure Cloud Direct Request | 13.7 tok/s | 1.00x (Baseline) | Requires Reliable WAN | N/A (Full RTT) |
5. Panduan Implementasi & Rekomendasi Arsitektural Enterprise
Bagi arsitek sistem dan *lead engineers* yang ingin mengadopsi pola AceSpec pada ekosistem enterprise:
- Pilih Pasangan Drafter-Target yang Terkalibrasi: Pastikan Small Language Model (SLM) di edge (misal: Qwen2.5-0.5B atau Gemma-2-2B) memiliki *vocabulary tokenizer* yang 100% kompatibel dengan Cloud Target Model (misal: Qwen2.5-72B atau Llama-3.3-70B) guna menghindari overhead penerjemahan token ID.
- Alokasikan Ring Buffer untuk State Cache: Batasi ukuran memory pool untuk *probabilistic state cache* di level 16MB–64MB per active connection dengan mekanisme evaporasi LRU untuk menjaga konsumsi RAM edge tetap deterministik.
- Gunakan Protokol Biner Kompak (Protocol Buffers / FlatBuffers): Hindari JSON berukuran besar pada jalur komunikasi edge-cloud. Serialisasikan *sparse indices* dan *compact distributions* ke format byte murni guna memaksimalkan efisiensi kompresi data.
Kesimpulan
AceSpec membuktikan bahwa kendala bandwidth jaringan bukan lagi penghalang utama untuk menghadirkan kapabilitas LLM skala frontier ke perangkat edge berdaya rendah. Dengan memadukan asymmetric wire protocol dan probabilistic state caching, sistem inferensi modern dapat mencapai efisiensi komunikasi maksimal dan kecepatan throughput optimal tanpa kompromi kualitas penalaran.
Referensi & Sumber Terverifikasi
- [1]AceSpec: An Asymmetric Edge-Cloud Collaborative Framework for Communication-Efficient LLM Inference(arXiv:2609.02514 [cs.DC] — Distributed, Parallel, and Cluster Computing)
- [2]Speculative Decoding: Accelerating LLM Inference via Draft Model Verification(IEEE Transactions on Parallel and Distributed Systems & ACM Surveys)
- [3]Edge-Cloud Distributed AI Systems Engineering Benchmark 2026(Cloud Native Computing Foundation (CNCF) & Edge AI Working Group)
Butuh Arsitektur Web & AI Berkualitas Tinggi?
Tim engineering NEWSAINT siap membantu merancang website berkecepatan tinggi, sistem AI autonomous, dan solusi SaaS terukur untuk bisnis Anda.
Artikel Terkait Lainnya

DecisionRAG (arXiv:2610.35868): Retriever-Free Retrieval via Decision Models — Eliminasi Capability Asymmetry, Hierarchical Tree Navigation, dan Rekor +17.4% Hit@1 Tanpa Indeks Vektor
Analisis arsitektur DecisionRAG (arXiv:2610.35868, Chao Wan, Paul Jünger, Beixi Du, Bodong Liu, Navaneetha Krishnan, Kilian Q. Weinberger — Cornell University & ASAPP): Mengapa retrieval konvensional (BM25, dense embeddings) menciptakan capability asymmetry terhadap LLM generator modern, dan bagaimana DecisionRAG menavigasi struktur korpus bertingkat menggunakan model keputusan (decision models) dalam konteks bersama (shared context) tanpa token generasi, menghasilkan lompatan +13.8 R@1 di MultiDoc2Dial, +17.4 Hit@1 di Natural Questions, dan latensi secepat 0.68 detik.

DynaFlow (arXiv:2610.34467): Free-Form Multi-Agent Orchestration — Sintesis Alur Kerja Eksekutabel, Eliminasi Defek Aliran Informasi, dan Lonjakan Akurasi 88.08% Tanpa Mengubah Bobot Sub-Agent
Analisis arsitektur DynaFlow (arXiv:2610.34467, Ruhao Liu et al., NUS): Mengapa topologi multi-agent statis memicu overhead komunikasi berlebihan, dan bagaimana integrasi sintesis alur kerja bebas ke dalam ruang aksi Main Agent — dikombinasikan dengan Two-Stage SFT dan kurasi 3 defek orkestrasi — menghasilkan akurasi 88.08% serta memecahkan 100% soal AIME dengan sub-agent berbobot beku.

Code Graphs & Embeddings pada Small Coding Agents (arXiv:2610.33958): Eksperimen 79k Episode SWE-bench, Gradien Hop Depth, dan Batasan Representasi Leksikal Satu-Langkah
Analisis empiris 79k episode SWE-bench Verified (arXiv:2610.33958, Saurav Bellam): Apakah tool knowledge graph dan embedding search benar-benar melengkapi pemahaman struktural coding agent kecil? Menyingkap degradasi hop gradient (odds ratio 0.50–0.67 per hop), anomali tool uptake pada model 32B, dan bukti linear probing bahwa representasi kode internal agen open-weight masih dominan bersifat leksikal satu-langkah.